

À la une
CRAM : Meta veut apprendre à Linux à utiliser de la RAM… qui ment sur sa taille
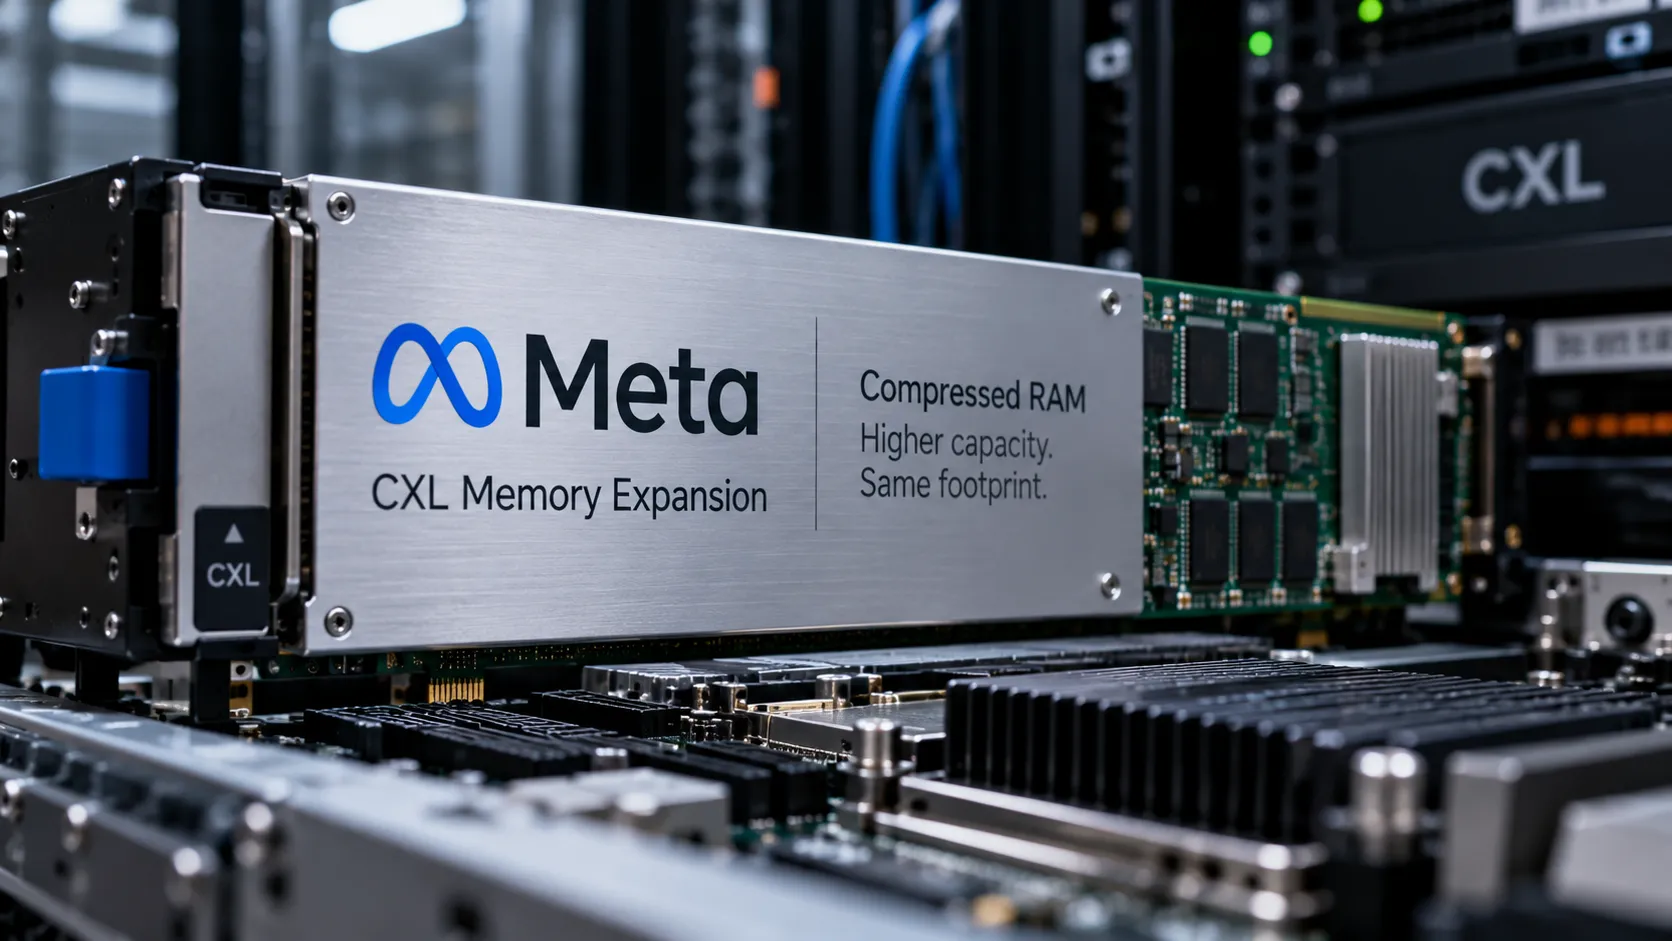
Linux sait déjà compresser sa mémoire avec zram ou zswap, mais Meta travaille sur une approche beaucoup plus étrange : de la RAM compressée directement par le matériel, accessible presque comme de la DRAM normale. Présenté cette semaine à la Linux Plumbers Conference 2026, CRAM permettrait au noyau de conserver des pages compressées dans des extensions mémoire CXL sans devoir les décompresser à chaque lecture. Les premiers tests annoncés approchent les performances de la DRAM dans certains scénarios. Le problème ? Un module de 1 To physique pourrait annoncer plusieurs téraoctets au système et soudain manquer réellement de place si les données refusent obstinément de se compresser. Meta doit donc apprendre au noyau Linux à gérer un périphérique dont la capacité est, littéralement, un mensonge.
Après zram et zswap, voici la RAM compressée qui reste de la RAM
Si vous utilisez Linux sur une machine avec peu de mémoire, vous connaissez peut-être déjà zram. Le principe consiste grossièrement à sacrifier un peu de CPU pour compresser des données en RAM et retarder le moment où le système devra écrire sur un stockage beaucoup plus lent. zswap suit une philosophie comparable mais agit comme un cache compressé devant le swap. Dans les deux cas, lorsqu’une donnée compressée doit redevenir utilisable normalement, le processeur doit intervenir et la décompresser. Meta travaille sur quelque chose de fondamentalement différent avec CRAM, son projet de Compressed RAM présenté à la Linux Plumbers Conference 2026 : la compression serait effectuée directement par un périphérique mémoire spécialisé, par exemple un expander CXL, capable de fournir des accès à l’échelle du cacheline ou même de l’octet. Les pages peuvent ainsi rester présentes dans les tables de pages et dans le page cache au lieu de provoquer une faute suivie d’une décompression logicielle à chaque consultation.
L’idée n’est donc pas de créer un « zram mais plus rapide ». Le matériel placé derrière CRAM compresse à l’écriture et restitue les données lors de la lecture de manière suffisamment transparente pour que le processeur puisse continuer à les considérer comme une forme de mémoire. Dans les mesures présentées par Gregory Price, ingénieur chez Meta, les lectures sur des données compressées atteignent des performances annoncées proches de la DRAM native, tandis que les écritures se montrent nettement plus rapides que zram, zswap ou le swap classique. Il s’agit toutefois de résultats présentés par l’équipe qui développe la technologie et non encore d’un benchmark indépendant universel : intéressant, oui ; nouvelle loi fondamentale de l’informatique, pas encore.
Le problème amusant : le module mémoire raconte n’importe quoi au noyau
Une extension mémoire compressée possède une particularité légèrement perturbante pour Linux : sa capacité logique peut être supérieure à sa capacité physique réelle. Gregory Price résume le problème dans la documentation du projet en expliquant que le périphérique « ment » sur sa taille. Imaginez un module contenant physiquement 256 Go de mémoire mais exposant au système une capacité beaucoup plus importante en supposant qu’un taux de compression donné sera atteint. Tant que les pages contiennent des données faciles à compresser, tout va bien. Puis quelqu’un remplit la mémoire de données chiffrées, de vidéo ou d’autres informations quasiment incompressibles et le merveilleux module de 512 Go virtuels se souvient soudainement qu’il n’en possède réellement que 256.
Pour un système d’exploitation, ce scénario est assez terrifiant. Le noyau Linux part traditionnellement du principe qu’une page mémoire qu’il a obtenue possède derrière elle une véritable capacité de stockage. Avec un module compressé, cette garantie disparaît. La proposition CRAM envoyée sur les listes du noyau Linux répond au problème en empêchant notamment les écritures incontrôlées dans ce niveau de mémoire : les pages placées dans CRAM sont protégées en écriture et une tentative de modification peut provoquer leur remontée vers la DRAM traditionnelle. Le périphérique peut également signaler qu’il approche de sa capacité physique réelle afin que le kernel cesse de lui envoyer de nouvelles pages et commence éventuellement à en évacuer.
De la DRAM chaude, de la RAM compressée tiède et du stockage froid
CRAM devient particulièrement intéressant lorsqu’on le regarde comme un nouvel étage dans la hiérarchie mémoire. Les données utilisées en permanence restent dans la DRAM rapide. Celles qui sont moins actives peuvent être « démotées » vers la mémoire compressée. Et si la pression continue d’augmenter, les pages les moins intéressantes peuvent toujours finir dans du swap traditionnel ou être libérées. Linux possède déjà une grande partie de la plomberie nécessaire grâce au memory tiering, à NUMA, au reclaim, au mécanisme de migration des pages et à la protection copy-on-write. Le projet CRAM cherche surtout à connecter intelligemment toutes ces briques à une nouvelle catégorie de matériel.
C’est ici qu’apparaît la notion de Private Memory NUMA Nodes. Meta travaille depuis plusieurs mois sur des nœuds NUMA particuliers qui restent visibles et gérés par le noyau mais sont exclus des allocations normales. Une application ne se retrouverait donc pas accidentellement avec une page importante allouée directement sur un périphérique compressé simplement parce que Linux cherchait un peu de place. CRAM peut au contraire y déplacer volontairement certaines pages via les mécanismes de demotion existants. Les pages continuent alors à vieillir dans les listes LRU traditionnelles et peuvent être récupérées lorsque le périphérique signale une pression trop forte.
CXL est la pièce matérielle qui rend tout cela beaucoup moins théorique
Cette architecture s’appuie notamment sur CXL, ou Compute Express Link, une technologie permettant de connecter de la mémoire et différents accélérateurs au processeur via l’infrastructure PCI Express tout en offrant des mécanismes adaptés au partage et à l’extension mémoire. Meta avait même proposé un pilote générique pour des contrôleurs CXL Type-3 capables de compresser la mémoire , afin de transformer ces régions en nœuds privés et de les enregistrer auprès de CRAM. La compression n’est alors plus un petit algorithme logiciel exécuté par vos cœurs CPU : elle devient une capacité du matériel mémoire lui-même.
C’est aussi pourquoi CRAM n’arrivera pas demain matin dans les paramètres de votre Steam Deck sous la forme d’un bouton « Doubler ma RAM ». Le projet vise d’abord une catégorie de serveurs disposant de mémoire CXL capable d’effectuer cette compression matériellement. Meta a évidemment d’excellentes raisons de s’y intéresser : à l’échelle d’un hyperscaler, augmenter la quantité de mémoire exploitable sans acheter exactement la même quantité de DRAM physique peut représenter énormément de matériel, d’énergie et d’argent. Le concept pourrait éventuellement descendre vers d’autres catégories de machines si l’écosystème matériel se développe, mais CRAM n’est aujourd’hui ni une fonction grand public ni quelque chose que l’on active uniquement par une mise à jour du kernel.
Samsung teste déjà le concept sur du vrai matériel CXL
Le projet ne vit toutefois plus uniquement dans un diagramme de conférence. En septembre, des ingénieurs de Samsung ont expliqué avoir testé la série de patches Private Memory Nodes sur un expander CXL réellement capable de compression. Leur retour décrit les résultats comme encourageants sur plusieurs aspects, notamment l’isolation offerte par les nœuds privés et les mécanismes de sélection des capacités. Voilà une validation externe intéressante : quelqu’un d’autre que Meta possède donc déjà du matériel suffisamment proche du modèle envisagé pour commencer à faire travailler le kernel dessus.
Tout n’est pas parfait pour autant. Les essais de Samsung ont également relevé davantage de page faults et d’allocation stalls , avec un impact sur certaines latences de queue. Les ingénieurs soupçonnent notamment la protection en écriture appliquée aux pages du niveau compressé. Ce détail est essentiel : une moyenne de performances impressionnante ne suffit pas dans un serveur si certaines requêtes se mettent occasionnellement à attendre beaucoup trop longtemps parce qu’une page doit être rapatriée en DRAM au mauvais moment. Le projet devra donc encore travailler sur la latence, le placement des données et les politiques déterminant quelles pages méritent réellement d’aller vivre dans ce grenier compressé.
Ce n’est pas encore dans Linux, et ce détail compte beaucoup
Malgré l’enthousiasme des premiers résultats, il faut éviter le titre « Linux double sa RAM grâce à Meta ». CRAM reste un travail en développement. La série Private Memory Nodes a évolué au fil de l’année et Gregory Price a même retiré l’exemple CRAM de la version v5 afin de faire progresser séparément l’infrastructure fondamentale du noyau. L’idée annoncée est de soumettre ensuite le service de mémoire compressée indépendamment si les bases nécessaires sont acceptées.
Une partie des mécanismes nécessaires existe déjà dans le noyau et les tests avancent, mais cela ne signifie ni que CRAM sera accepté sous cette forme, ni qu’il arrivera dans Linux 7.4 ou une autre version précise. Les discussions du kernel peuvent parfaitement modifier l’API, séparer certaines fonctions ou demander une approche complètement différente. C’est même un peu la définition du processus : proposer quelque chose, découvrir que quinze personnes connaissent une situation bizarre impliquant NUMA sur POWER9 en 2019, recommencer. Le matériel compressé pose en plus des questions de sécurité des données, de gestion de capacité et de comportement lors des pires scénarios, autant de sujets sur lesquels le noyau n’aime généralement pas la phrase « normalement ça devrait aller ».
Est-ce que CRAM remplacera zram et zswap ? Probablement pas sur votre laptop
Comparer CRAM à zram et zswap est utile pour comprendre son fonctionnement, mais ce ne sont pas exactement des concurrents équivalents. zram est entièrement logiciel et fonctionne aujourd’hui sur pratiquement n’importe quelle machine. Il est particulièrement utile sur les PC, smartphones, Raspberry Pi et autres systèmes où gagner quelques gigaoctets virtuels vaut largement un peu de temps CPU. zswap s’intègre quant à lui au chemin de swap existant. CRAM exige du matériel spécialisé, mais peut en échange garder les données compressées directement accessibles sans le même cycle de décompression logicielle à chaque lecture.
On peut donc imaginer un futur serveur utilisant simultanément plusieurs techniques plutôt qu’un gagnant unique : DRAM pour les données chaudes, mémoire CXL compressée pour le gros ventre du dataset, zswap ou d’autres mécanismes pour amortir certaines situations et stockage persistant tout en bas. Le noyau Linux deviendrait alors moins un simple gestionnaire de RAM qu’un chef de gare chargé d’envoyer chaque page vers la classe de wagon correspondant à son importance. Ce qui est nettement plus élégant que l’approche classique consistant à découvrir que la RAM est pleine quand kswapd commence soudainement à aspirer un cœur CPU.
Si ça marche, « combien de RAM possède ce serveur ? » va devenir une question compliquée
CRAM illustre surtout une évolution fascinante de l’informatique moderne : la quantité de mémoire physique n’est plus nécessairement la quantité de mémoire que le logiciel pense avoir à sa disposition. Entre compression, CXL, memory tiering, mémoire distante et accélérateurs, le vieux modèle « j’ai huit barrettes de 64 Go donc j’ai 512 Go de RAM » commence à manquer sérieusement de vocabulaire.
Dans le cas d’un module compressé, cette ambiguïté devient littérale. Une machine pourrait disposer physiquement d’une certaine quantité de mémoire et exposer une capacité logique bien plus importante, dont la taille réellement utilisable changerait en fonction de la compressibilité des données. Les zéros, le texte et certaines structures seraient des locataires très économiques. Un gros bloc de données déjà compressées arriverait avec cinq valises, trois enfants et refuserait de partager la chambre.
Le travail de Meta consiste donc moins à « compresser de la RAM » — nous savons faire cela depuis longtemps — qu’à apprendre à Linux comment faire confiance juste ce qu’il faut à une mémoire dont la capacité n’est pas fixe.
Et si le noyau finit par accepter cette idée, nos futurs serveurs auront peut-être de la RAM physique, de la RAM logique, de la RAM compressée et une quantité utilisable qui dépend du contenu.
Essayez donc maintenant d’expliquer ça au configurateur Dell.
Sources & références
- Linux Plumbers Conference 2026 — A Compressed RAM Service
- Linux Kernel Mailing List — mm/cram: add compressed ram memory management subsystem
- Linux Kernel — cxl_compression PCI driver
- Linux Kernel Mailing List — Tests Samsung des Private Memory Nodes
- Phoronix — Meta Developing Compressed RAM “CRAM” For Linux
- Hardware Busters — Meta’s CRAM Wants Compressed RAM to Behave Like Real Memory
Communauté
Commentaires
Aucun commentaire pour le moment. Soyez le premier à réagir.