
À la une
Linus Torvalds utilise l’IA pour optimiser Linux : un gain de 23 fois… et un bug repéré dans le code
Linus Torvalds vient de faire quelque chose qui aurait encore surpris pas mal de développeurs il y a quelques années : utiliser une intelligence artificielle pour l'aider à modifier le noyau Linux. Résultat annoncé : jusqu'à 23 fois plus de lectures par seconde dans un benchmark particulièrement exigeant. Mais derrière ce chiffre spectaculaire se cache une histoire beaucoup plus intéressante, mêlant programmation concurrente, relecture humaine et bug découvert avant l'intégration du correctif. Une démonstration assez parlante de ce que l'IA peut apporter au développement logiciel, mais aussi de ses limites.
Quand Linus Torvalds publie une modification du noyau Linux, l'événement mérite généralement l'attention des développeurs. Quand cette modification a été préparée avec l'aide d'une intelligence artificielle et affiche un gain de performances de 2 200 % dans un test, difficile de passer à côté. Mais le plus intéressant dans cette histoire n'est probablement pas le chiffre affiché sur le benchmark.
Le 13 octobre 2026, le créateur de Linux a présenté sur la liste de diffusion du noyau une série de dix correctifs destinés à résoudre un ancien problème de performances lors de la lecture de fichiers. Pour mener ce travail, il explique avoir utilisé un grand modèle de langage afin de l'aider à surmonter des difficultés techniques sur lesquelles plusieurs développeurs s'étaient déjà cassé les dents.
L'expérimentation intervient alors que l'utilisation des assistants IA dans le développement du noyau Linux fait l'objet de discussions de plus en plus sérieuses. Et contrairement aux démonstrations habituelles où un agent génère une application complète en quelques minutes, Torvalds s'est attaqué à l'une des parties les plus sensibles d'un système d'exploitation : la gestion de la mémoire.
Le résultat est prometteur, mais il faut immédiatement préciser deux choses. Le correctif reste expérimental et n'a pas encore été intégré à la branche principale du noyau. Surtout, sa relecture par d'autres développeurs a déjà révélé un problème de concurrence susceptible de produire des lectures incorrectes.
Autrement dit, l'IA a aidé à obtenir un résultat impressionnant, mais les humains ont encore eu du travail derrière.
Le problème : plusieurs processeurs se disputaient le même compteur
Pour comprendre l'intérêt de cette modification, il faut s'intéresser à un mécanisme assez discret de Linux : le page cache. Lorsque vous ouvrez un fichier, le système peut conserver une partie de son contenu en mémoire vive afin d'éviter de retourner systématiquement lire les données sur le disque.
Ce fonctionnement est particulièrement utile pour les bibliothèques partagées, les bases de données et les applications qui accèdent régulièrement aux mêmes fichiers. Tant que les données nécessaires sont présentes en RAM, leur lecture peut être beaucoup plus rapide qu'un accès au SSD, même moderne.
Le problème apparaît lorsque de nombreux cœurs de processeur souhaitent accéder simultanément aux mêmes données. Pour éviter de libérer une zone de mémoire encore utilisée, Linux s'appuie notamment sur des compteurs de références. Chaque lecteur doit signaler qu'il utilise cette zone, puis retirer sa référence lorsqu'il a terminé.
Imaginez un supermarché dans lequel chaque client doit faire tamponner un ticket au même guichet avant de prendre un produit, puis repasser au guichet en sortant. Avec deux personnes, l'organisation fonctionne correctement. Avec soixante-quatre clients qui arrivent au même moment, le guichet devient rapidement le véritable problème, même si les rayons sont parfaitement approvisionnés.
C'est exactement le genre de situation que les développeurs appellent une contention. Plusieurs processeurs veulent modifier la même petite zone de mémoire, ce qui oblige leurs caches internes à se synchroniser en permanence. À mesure que le nombre de cœurs augmente, ce mécanisme peut devenir suffisamment coûteux pour annuler une partie des bénéfices du parallélisme.
Ce problème était connu depuis plusieurs années. Torvalds avait déjà proposé une première approche en 2024, puis d'autres développeurs avaient tenté différentes solutions. Certaines amélioraient les performances, mais introduisaient des complications dans la gestion des pages mémoire ou dans la manière de garantir leur validité pendant une lecture.
Cette fois, le créateur de Linux a décidé de reprendre le dossier avec l'aide d'un assistant IA.
Une astuce pour lire la mémoire sans bloquer tout le monde
La solution proposée repose sur une idée relativement simple à expliquer, mais délicate à implémenter correctement : ne plus obliger chaque lecture à modifier systématiquement un compteur partagé.
Pour y parvenir, les correctifs utilisent un mécanisme connu sous le nom de RCU, pour Read-Copy Update. Très utilisé dans Linux, il permet à des lecteurs d'accéder à certaines structures de données pendant que d'autres parties du système les modifient, à condition de respecter des règles précises concernant leur durée de vie.
Dans l'approche de Torvalds, certaines pages fréquemment utilisées ne sont plus libérées immédiatement lorsqu'elles quittent le cache. Le noyau attend la fin d'une période de grâce RCU, ce qui garantit que les lecteurs déjà engagés dans une section protégée peuvent terminer leur travail.
Cette organisation rend possible un chemin de lecture beaucoup moins coûteux. Au lieu de prendre puis de relâcher une référence à chaque accès, le processeur peut lire directement les données tant que les conditions de sécurité sont réunies.
Le bénéfice potentiel devient considérable lorsque des dizaines de cœurs veulent consulter simultanément la même page mémoire. Ils n'ont plus besoin de se disputer aussi souvent l'écriture du compteur qui posait problème.
C'est précisément le genre d'optimisation qui illustre la difficulté du développement d'un noyau. Retirer une opération coûteuse peut sembler évident, mais encore faut-il garantir que la mémoire reste valide et que les données lues correspondent bien à la version attendue.
Le gain de vitesse ne doit jamais se faire au prix de résultats incorrects. Dans un jeu vidéo, un petit problème de synchronisation peut provoquer une animation étrange. Dans un noyau, une erreur de ce type peut compromettre le comportement de nombreuses applications.
23 fois plus rapide : le chiffre est réel, mais pas celui que vous imaginez
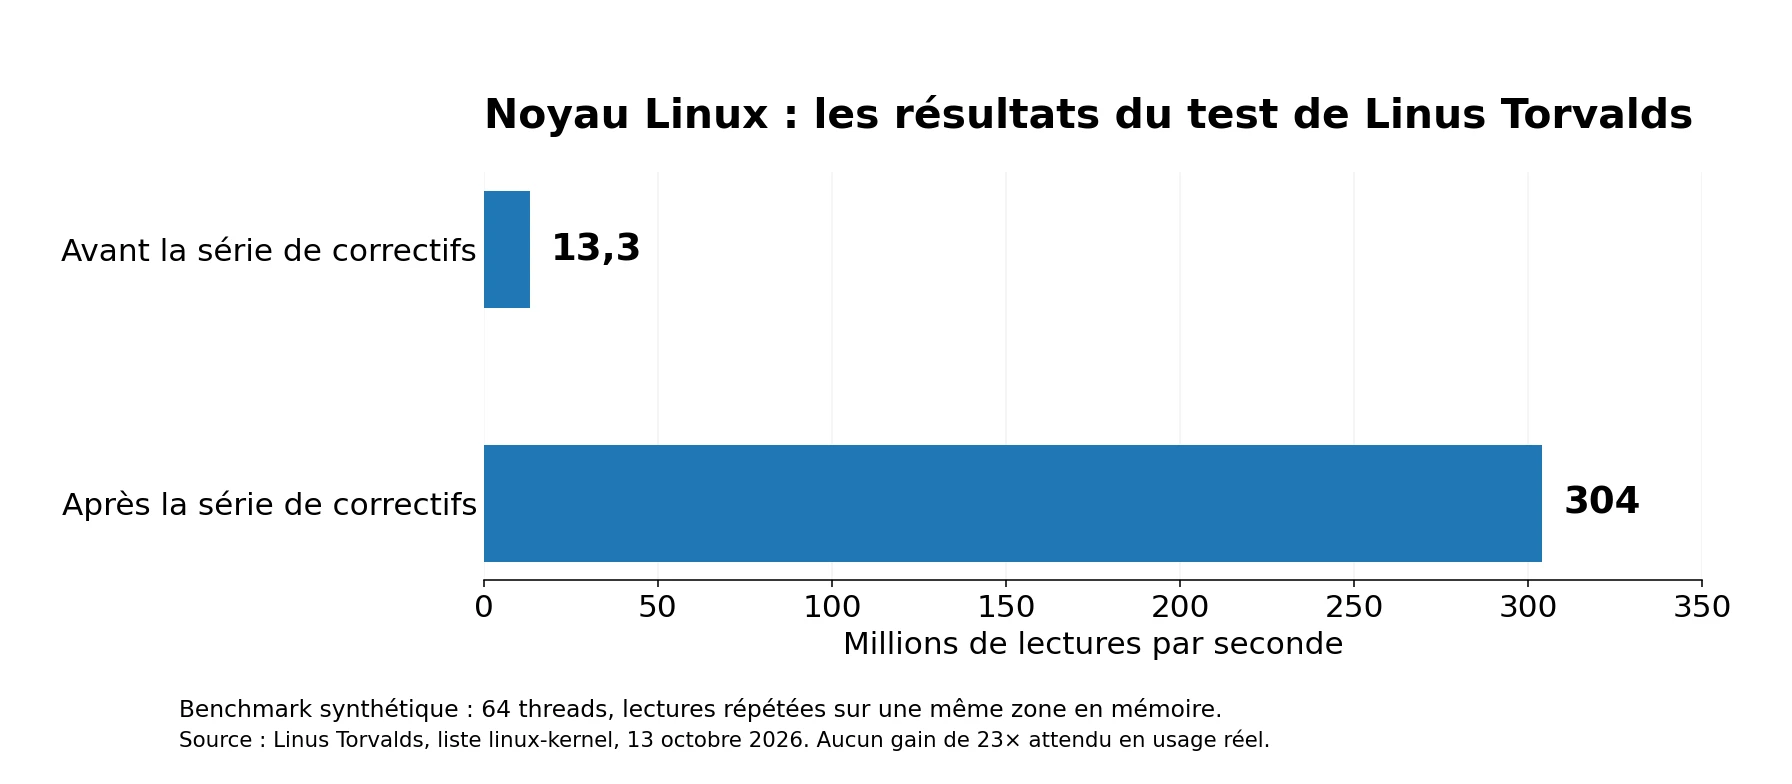
Graphique original GeekParadize établi à partir des mesures publiées par Linus Torvalds le 13 octobre 2026. Les valeurs concernent uniquement le benchmark synthétique décrit dans l'article.
Pour évaluer ses modifications, Torvalds a effectué des mesures sur une machine équipée d'un processeur AMD Ryzen Threadripper, avec 32 cœurs physiques et 64 threads.
Le benchmark consistait à lire continuellement une toute petite portion d'un même fichier depuis plusieurs threads. Dans cette situation volontairement extrême, la version initiale du noyau plafonnait à environ 13,3 millions de lectures par seconde.
Après application des correctifs expérimentaux, le résultat annoncé atteint 304 millions de lectures par seconde.
La différence représente une multiplication des performances par environ 22,9, ce qui explique le fameux facteur 23 repris dans les titres de plusieurs médias spécialisés.
Mais Torvalds lui-même prend soin de relativiser ce résultat dans son message original. Le test reproduit une situation artificielle dans laquelle tous les threads relisent sans arrêt la même petite zone mémoire. Les gains observés dans des applications réelles seront beaucoup plus modestes.
Il ne faut donc absolument pas comprendre qu'une future version de Linux démarrera 23 fois plus rapidement, que vos jeux gagneront 2 300 % de FPS ou que votre navigateur deviendra soudain capable d'ouvrir deux cents onglets sans broncher.
L'objectif du benchmark est de mesurer l'élimination d'un goulot d'étranglement bien précis. Dans ce contexte, il montre que les lectures peuvent désormais mieux profiter de la multiplication des cœurs.
Les effets pratiques dépendront cependant fortement des logiciels et de la manière dont ils utilisent le système de fichiers. Certaines applications pourraient bénéficier de cette optimisation, notamment celles réalisant énormément de lectures concurrentes. D'autres ne remarqueraient probablement aucune différence.
Il existe même des situations particulières dans lesquelles cette nouvelle approche peut entraîner un surcoût, notamment lorsque la lecture provoque certains défauts de page. Une bonne optimisation du noyau ne consiste donc pas seulement à améliorer son meilleur résultat, mais aussi à vérifier qu'elle ne pénalise pas excessivement les autres scénarios.
Le détail qui change tout : la revue humaine a trouvé un bug
C'est ici que cette expérimentation devient particulièrement intéressante.
Peu après la publication de la série de correctifs, le développeur Kiryl Shutsemau, spécialiste de la gestion mémoire du noyau, a signalé une condition de concurrence dans le nouveau chemin de lecture.
Dans certaines circonstances, une page mémoire pouvait être remplacée pendant qu'un autre processeur tentait de la lire. Si la taille du fichier évoluait au mauvais moment, la logique proposée risquait alors de renvoyer des données ne correspondant pas à celles qui avaient réellement été écrites.
Ce type de problème est particulièrement difficile à détecter. Le programme peut fonctionner parfaitement pendant des milliers d'exécutions, puis produire un résultat incorrect lorsque plusieurs opérations se déroulent dans un ordre très particulier.
La difficulté vient du fait que les événements n'arrivent pas nécessairement dans le même ordre d'une exécution à l'autre. Un test classique peut donc passer sans problème alors qu'un scénario concurrent reste dangereux.
Torvalds n'a pas rejeté la remarque. Il a au contraire discuté d'une modification permettant de déplacer certaines vérifications et de simplifier le contrôle de validité des pages. Les échanges se sont poursuivis publiquement afin d'améliorer la proposition.
D'autres mainteneurs ont également soulevé des questions sur la consommation mémoire et la manière dont Linux doit gérer les pages dont la libération est volontairement retardée. Là encore, une optimisation locale peut avoir des conséquences plus larges sur le fonctionnement général du système.
Le point essentiel est que le bug a été identifié pendant la phase de revue, avant l'intégration du code dans une version officielle du noyau. Ce n'est donc pas une nouvelle vulnérabilité affectant tous les ordinateurs Linux, mais un problème découvert dans une proposition encore expérimentale.
Cette différence est importante, et elle illustre précisément l'intérêt du processus de développement ouvert : le code est publié, discuté, critiqué et corrigé avant d'être éventuellement accepté.
Linus Torvalds et l'IA : ni rejet automatique, ni confiance aveugle
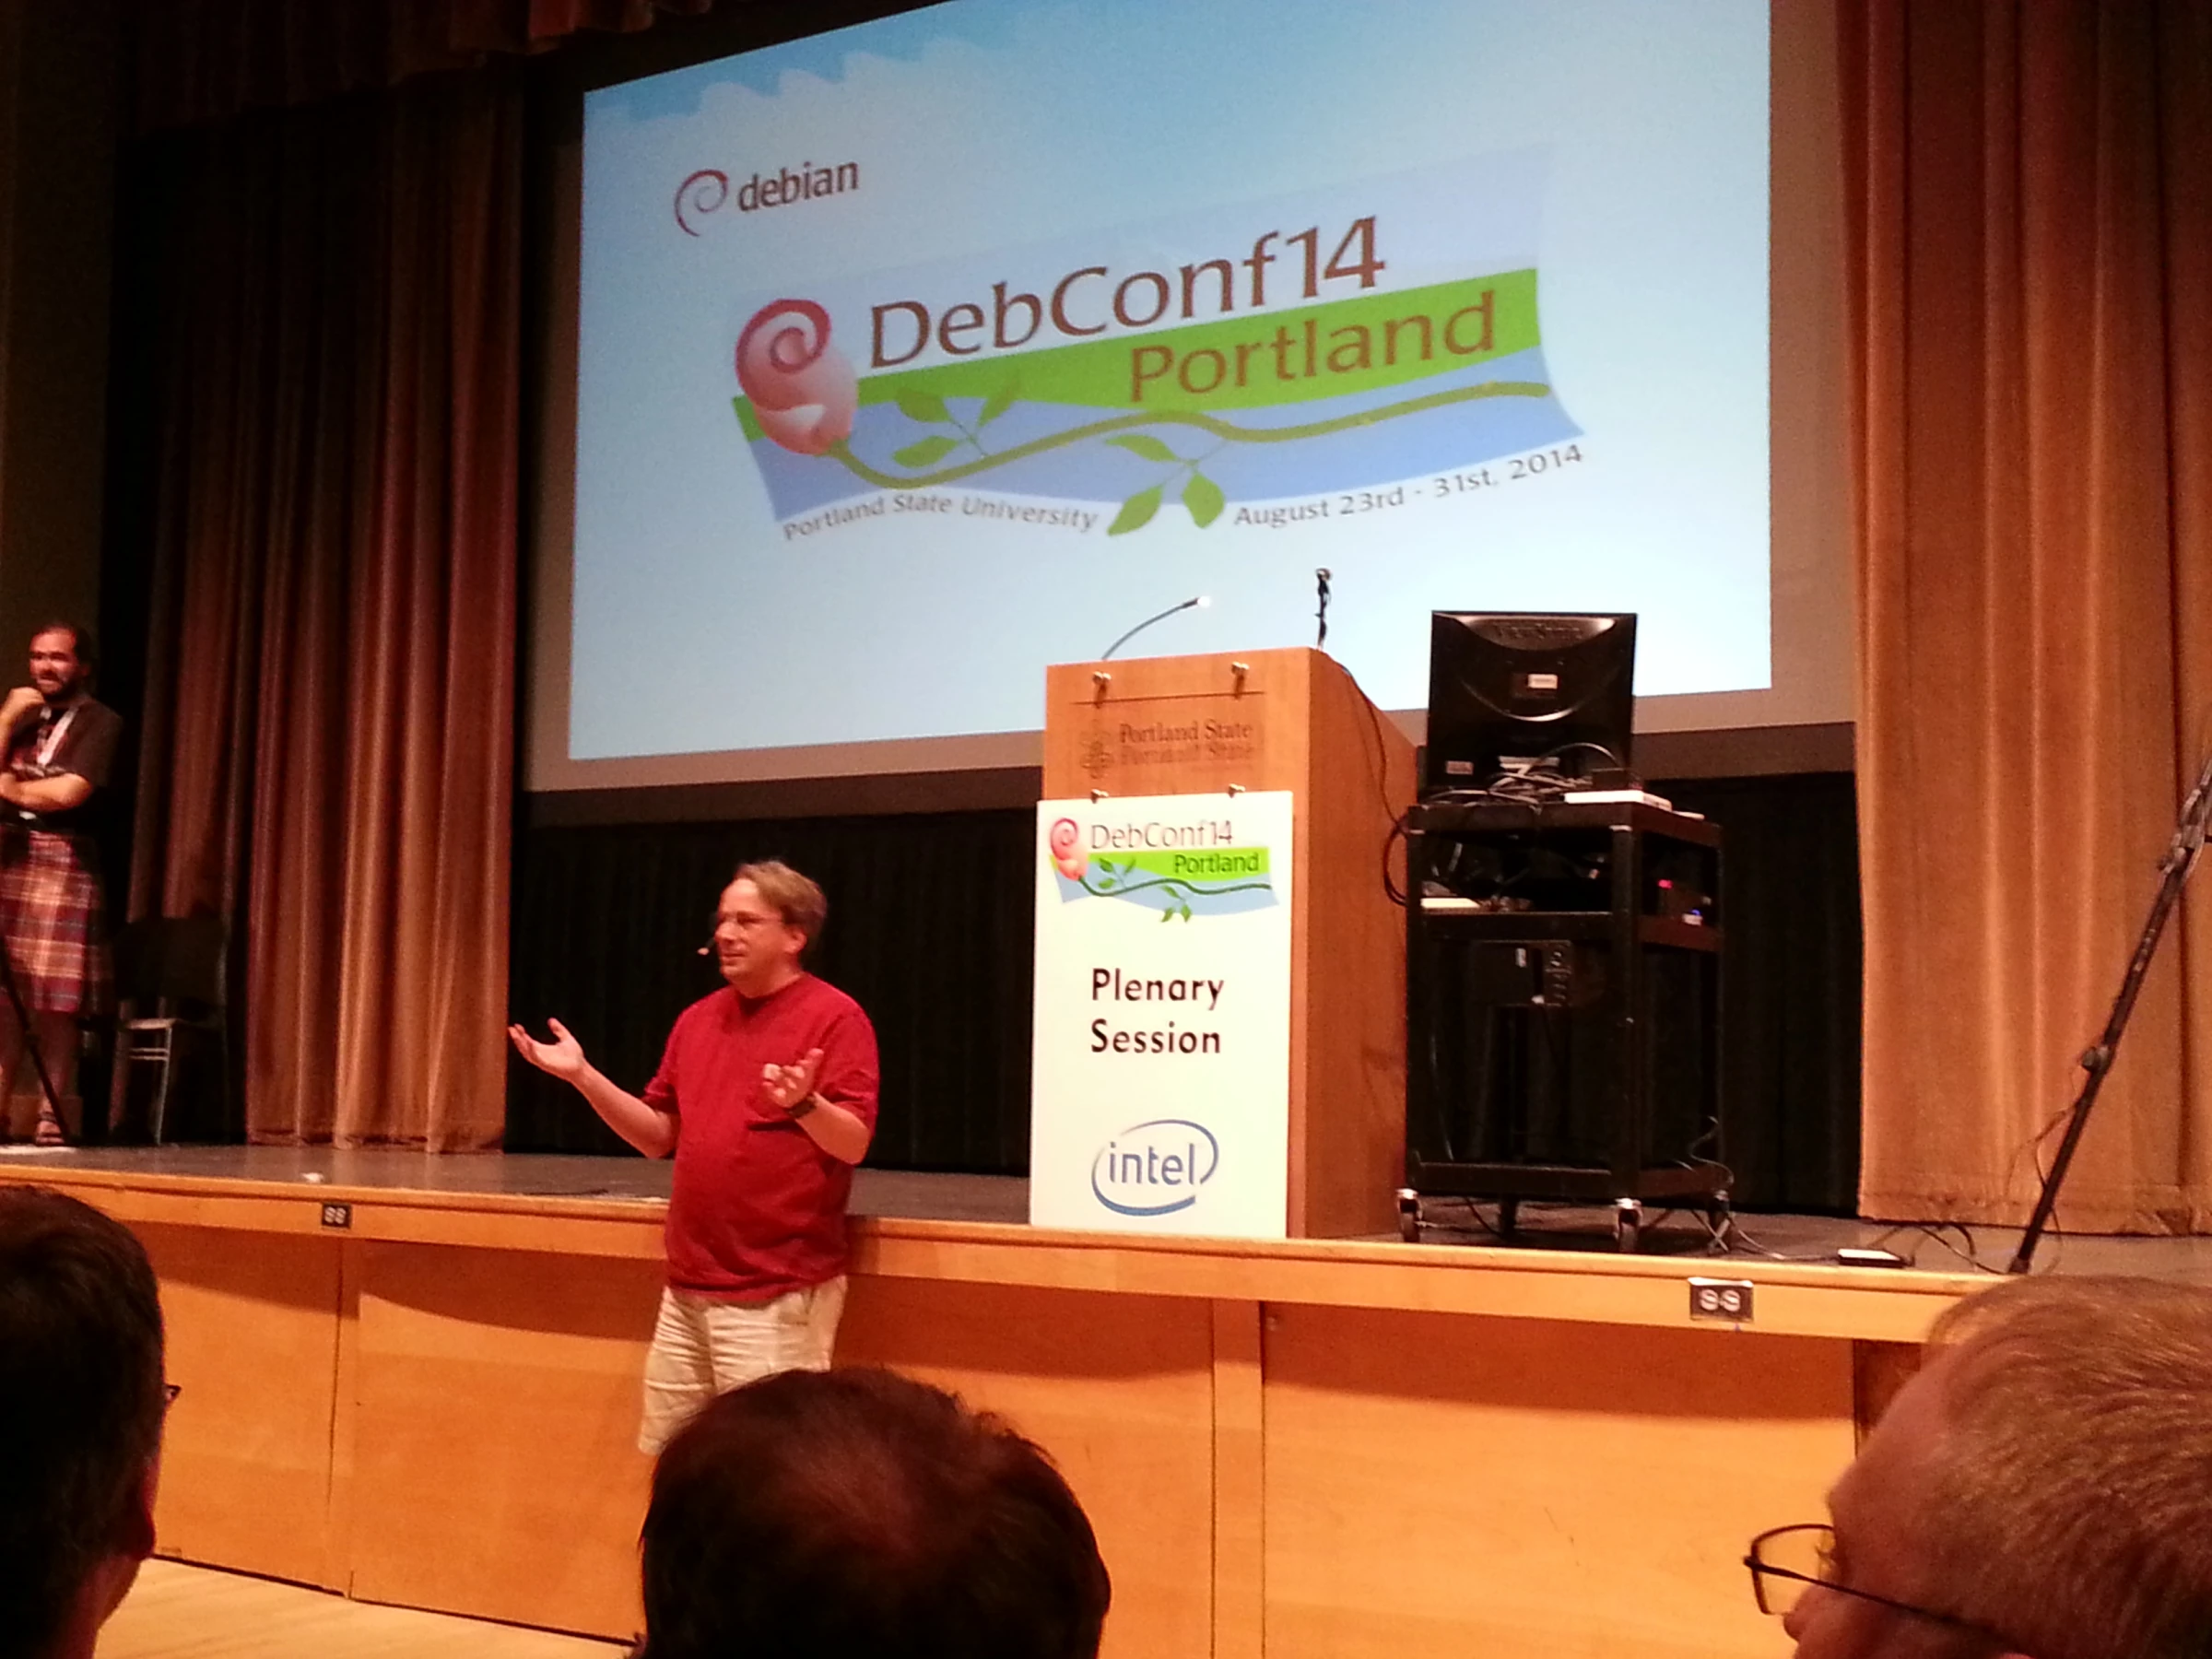
Crédit : Elizabeth Krumbach Joseph, licence CC BY 2.0. Fichier original et conditions d'utilisation
La participation d'un assistant IA à ces correctifs possède également une dimension symbolique. Pendant longtemps, Linus Torvalds a été associé à une approche particulièrement exigeante de la qualité du code, avec des remarques parfois très directes envers les contributions jugées insuffisantes.
Son utilisation de l'intelligence artificielle ne signifie pourtant pas qu'il a soudain décidé de laisser un chatbot écrire Linux à sa place.
Dans les informations accompagnant les premiers correctifs, Torvalds explique avoir utilisé Claude Code pour l'aider à travailler sur le code, préparer des programmes de test et effectuer une partie des vérifications. Les mesures ont ensuite été exécutées sur ses propres machines.
La distinction est essentielle. L'assistant contribue au travail de développement, mais il ne possède ni l'expérience ni la responsabilité du mainteneur qui soumet les modifications.
Le noyau Linux repose sur un processus de contribution dans lequel les développeurs signent leurs changements et acceptent d'en assumer la responsabilité. L'utilisation d'un modèle de langage ne supprime pas ces obligations.
Cette expérimentation intervient également dans un contexte où les équipes Linux discutent de la place des outils IA dans les revues de code. Certains y voient un moyen de repérer plus rapidement les erreurs et d'automatiser des tâches répétitives. D'autres s'inquiètent de la multiplication de contributions insuffisamment vérifiées ou de rapports de bugs générés automatiquement.
Les deux inquiétudes ne sont d'ailleurs pas incompatibles.
Un assistant peut être extrêmement utile lorsqu'il travaille sous la supervision d'un développeur expérimenté. Le même outil peut devenir une source de travail supplémentaire si ses résultats sont envoyés sans vérification aux mainteneurs d'un projet.
Et lorsqu'on parle du noyau qui fait fonctionner une bonne partie des serveurs, smartphones et infrastructures informatiques de la planète, la différence entre les deux scénarios mérite quelques précautions.
Une expérimentation plus intéressante qu'une démonstration spectaculaire
L'histoire de ces correctifs résume finalement assez bien l'état actuel de l'intelligence artificielle appliquée à la programmation.
D'un côté, un outil capable d'aider un développeur particulièrement expérimenté à revisiter un problème ancien et à obtenir un résultat technique prometteur. De l'autre, une erreur de concurrence découverte lors de la revue par un spécialiste humain, qui rappelle qu'un programme rapide n'est pas nécessairement un programme correct.
Le plus important reste donc ce qui se passera après cette première publication. Les correctifs devront être améliorés, testés sur différentes architectures, confrontés à des charges de travail moins artificielles et examinés par les mainteneurs concernés.
Il faudra également déterminer si les bénéfices justifient la complexité supplémentaire introduite dans la gestion mémoire. Un changement de cette nature ne peut pas être accepté uniquement parce qu'il produit un joli graphique de performances.
À ce stade, la série reste dans une branche expérimentale du dépôt de Torvalds. Aucune version stable de Linux ne bénéficie automatiquement de cette optimisation, et aucune date d'intégration définitive n'est garantie.
Mais l'expérience apporte déjà un enseignement assez précieux. L'IA peut participer à des travaux très techniques, y compris dans un projet aussi complexe que Linux, sans que cela oblige à abandonner les principes traditionnels de revue, de responsabilité et de validation.
Le futur du développement logiciel ne sera probablement pas une opposition aussi simple entre des humains qui écrivent tout à la main et des machines qui font absolument tout à leur place. Il ressemblera peut-être davantage à cette expérimentation : un développeur expérimenté utilise l'IA pour avancer plus vite, puis soumet son travail à des collègues capables de lui expliquer pourquoi son idée comporte encore un problème.
Un benchmark multiplié par 23, un bug découvert avant la fusion et plusieurs ingénieurs autour de la table : voilà une démonstration de l'IA dans le développement logiciel autrement plus instructive qu'une vidéo promettant de créer le prochain Linux en trois prompts.
Et si même Linus Torvalds accepte désormais de demander un coup de main à un modèle de langage, le plus important reste peut-être ce qu'il fait ensuite : lire le code, comprendre les implications et accepter qu'un autre développeur lui dise qu'il faut encore le corriger.
Sources & références
- Linus Torvalds — Improve page refcount scalability, liste linux-kernel
- Linus Torvalds — Réponse au signalement de Kiryl Shutsemau
- Kiryl Shutsemau — Suite de la discussion technique
- Tom's Hardware — Linus Torvalds posts his first AI-assisted patch to the Linux kernel
- The New Stack — Linus Torvalds let Claude Code fix the Linux page cache
- Wikimedia Commons — Linus Torvalds at DebConf14
Communauté
Commentaires
Aucun commentaire pour le moment. Soyez le premier à réagir.