

À la une
DeepSeek et Huawei veulent casser le verrou CUDA : leur pile IA Ascend passe à l’open source
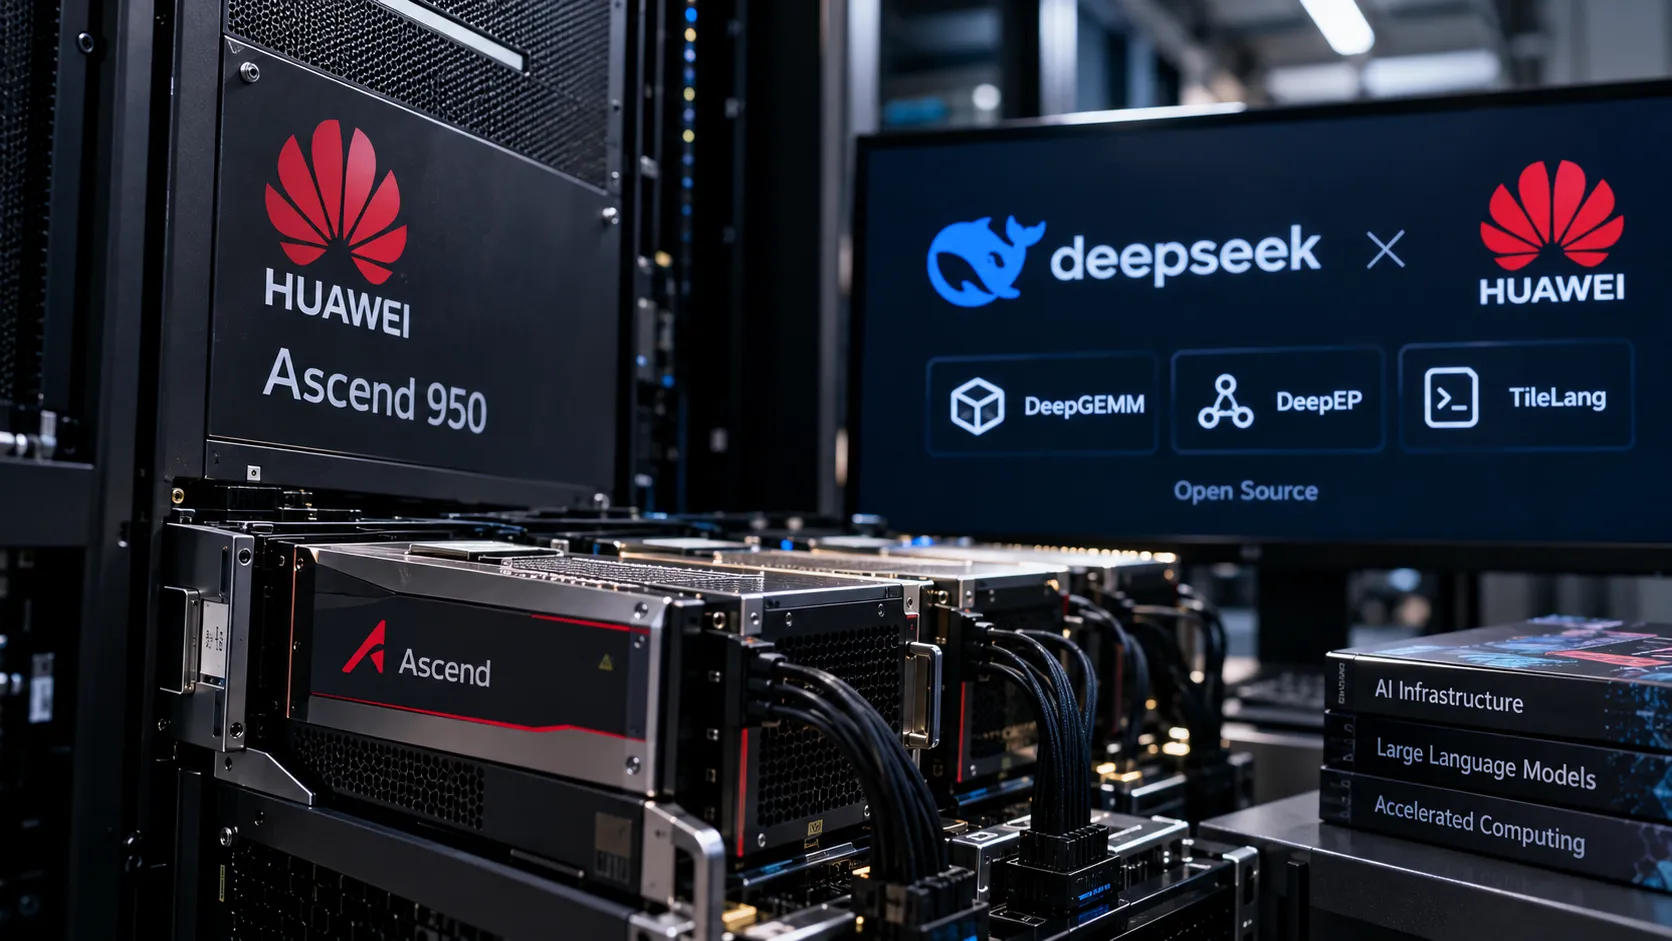
Nvidia ne domine pas l’intelligence artificielle uniquement grâce à ses GPU. Son véritable trésor s’appelle CUDA : quinze ans de bibliothèques, d’outils et d’habitudes qui rendent extrêmement coûteux le passage vers un autre accélérateur. DeepSeek et Huawei viennent justement d’attaquer cette couche logicielle en publiant plusieurs briques open source capables de faire tourner les kernels utilisés par DeepSeek sur les NPU Ascend 950. DeepGEMM pour les multiplications de matrices, DeepEP pour faire communiquer les accélérateurs et surtout TileLang, un langage Pythonique désormais capable de cibler Nvidia comme Huawei. Non, CUDA n’est pas mort. Mais pour la première fois, la question « et si je changeais de GPU ? » commence à obtenir une réponse qui ne nécessite pas forcément de réécrire la moitié du datacenter.
Le vrai château fort de Nvidia n’est pas seulement le GPU
Quand on parle de la domination de Nvidia dans l’IA, la conversation tourne naturellement autour des H100, B200 et autres accélérateurs suffisamment chers pour provoquer un léger malaise au moment de remplir le bon de commande. Pourtant, le matériel ne représente qu’une partie du problème. Le véritable avantage accumulé par Nvidia se trouve dans CUDA et tout son écosystème logiciel : compilateurs, bibliothèques mathématiques, communication entre GPU, kernels optimisés, outils de profilage et quantité de frameworks conçus autour de cette plateforme. Changer de puce peut donc signifier changer une grosse partie du logiciel qui a été patiemment optimisé pour elle.
C’est précisément ce que DeepSeek cherche à réduire. Le 30 septembre, l’entreprise a annoncé avec Huawei une série d’outils open source destinés aux accélérateurs Ascend. Reuters décrit cette collaboration comme une tentative explicite de réduire la dépendance à l’écosystème Nvidia, tandis que DeepSeek a publié directement plusieurs composants sur GitHub. L’objectif n’est pas de recréer CUDA instruction par instruction, mais de proposer suffisamment de briques compatibles pour que les logiciels IA développés sur une plateforme puissent migrer beaucoup plus facilement vers une autre.
DeepGEMM-Ascend : les grosses multiplications changent de puce sans changer d’API
La première pièce s’appelle DeepGEMM-Ascend. Une GEMM est essentiellement une grosse multiplication de matrices, ce qui semble beaucoup moins spectaculaire qu’un modèle générant une vidéo mais constitue une bonne partie du travail réellement effectué par les accélérateurs d’IA. DeepSeek possédait déjà DeepGEMM pour les GPU Nvidia. La nouvelle version Ascend publiée sous licence MIT conserve les mêmes API tout en ciblant les NPU Huawei Ascend 950. Elle prend notamment en charge les calculs BF16, FP8 et FP4 ainsi que plusieurs opérations destinées aux architectures Mixture-of-Experts utilisées par les grands modèles.
C’est là que l’approche devient intéressante pour les développeurs. Au lieu de maintenir une implémentation Nvidia puis de reconstruire manuellement tout le code critique pour Huawei, DeepSeek essaie de conserver le même modèle de programmation au-dessus de kernels différents. Le dépôt explique utiliser des optimisations spécifiques à Ascend — chargement sparse, pipeline basé sur des coroutines, gestion particulière des layouts mémoire — tout en masquant une grande partie de cette complexité derrière une interface familière. Les performances publiées sont celles de DeepSeek et doivent donc être considérées comme des mesures de l’éditeur, mais le projet affirme approcher les limites matérielles de l’Ascend 950 sur de nombreuses formes de matrices. En gros, l’objectif n’est pas seulement « ça compile ». C’est « ça compile sans transformer votre accélérateur à plusieurs milliers d’euros en calculatrice Casio ».
DeepEP-Ascend s’occupe du moment où 128 accélérateurs doivent se parler
Calculer rapidement sur une puce ne suffit plus lorsque les modèles modernes sont répartis sur des dizaines ou centaines d’accélérateurs. Une architecture Mixture-of-Experts doit notamment déplacer en permanence des données entre différentes puces selon les experts sélectionnés pour chaque token. Si cette communication devient trop lente, les magnifiques téraflops inscrits sur la fiche technique passent une partie de leur journée à attendre leurs voisins.
DeepSeek a donc également publié DeepEP-Ascend, sa bibliothèque de communication pour les NPU Huawei. L’API publique reste alignée avec la version Nvidia de DeepEP, tandis que l’implémentation exploite les technologies Ascend comme HCCL, HCOMM, UBMEM et URMA. Les benchmarks fournis par le projet vont jusqu’à 128 ranks et annoncent entre 313 et 320 Go/s pour certaines opérations de distribution à cette échelle, avec de meilleures performances encore sur des groupes plus petits. Là encore, ce sont des chiffres publiés par DeepSeek sur son propre environnement de validation, pas un benchmark indépendant, mais ils montrent surtout que le travail ne se limite pas à quelques démos sur une seule carte.
TileLang est peut-être la pièce la plus importante
DeepGEMM et DeepEP sont très spécialisés. La partie potentiellement plus structurante s’appelle TileLang. Ce projet open source est un langage spécifique au domaine permettant d’écrire des kernels de calcul avec une syntaxe Pythonique, puis de laisser son compilateur produire le code adapté au matériel. Depuis le 30 septembre, TileLang prend officiellement en charge les Huawei Ascend 950 avec génération de code native, planification automatique, synchronisation et programmation vectorielle SIMD/SIMT.
Le mot important ici est multi-backend. TileLang travaillait déjà autour de CUDA et a progressivement ajouté d’autres chemins matériels, notamment ROCm et Metal. L’idée n’est donc pas vraiment de construire « le CUDA de Huawei », mais quelque chose de potentiellement plus gênant pour Nvidia : une couche au-dessus du matériel permettant au développeur d’écrire davantage de code commun. DeepSeek affirme qu’un modèle de programmation de haut niveau plus simple peut conserver l’essentiel des performances tout en réduisant la quantité de code spécifique à chaque architecture. Reuters rapporte même que l’entreprise présente TileLang comme offrant un modèle de programmation plus simple que CUDA. C’est une affirmation de DeepSeek, pas encore une loi de la physique, mais la direction est intéressante.
Le même Python, Nvidia d’un côté et Huawei de l’autre
C’est probablement la partie la plus importante pour comprendre ce qui se joue. Lorsqu’une entreprise choisit un accélérateur IA, elle n’achète pas uniquement du silicium. Elle engage aussi ses développeurs sur les bibliothèques, outils et pratiques de ce fournisseur. Plus le logiciel contient de kernels CUDA spécifiques, plus changer de matériel devient coûteux.
DeepSeek essaie désormais d’aligner ses bibliothèques afin que les mêmes API Python puissent sélectionner différents backends. Son projet TileKernels indique par exemple avoir ajouté Ascend en suivant le chemin Nvidia existant, le backend approprié étant sélectionné à l’exécution. DeepGEMM-Ascend reprend de la même façon les interfaces du projet original. DeepEP reproduit également l’API publique de son équivalent Nvidia. Ce ne sera évidemment jamais totalement transparent — les architectures ont des capacités, des mémoires et des interconnexions différentes — mais chaque couche commune réduit le coût du changement.
On pourrait résumer la stratégie ainsi : le développeur continue à parler Python et TileLang pendant que les ingénieurs très courageux qui aiment lire des manuels de 900 pages s’occupent de convaincre le silicium situé dessous. Pour la plupart d’entre nous, c’est un partage du travail parfaitement acceptable.
Attention : Huawei possède toujours sa propre grosse pile logicielle
Il serait toutefois très exagéré d’annoncer la mort de CUDA ou l’arrivée d’une plateforme totalement indépendante. Les bibliothèques publiées par DeepSeek ont toujours besoin de CANN, la pile logicielle de Huawei pour Ascend, ainsi que de torch_npu, de pilotes spécifiques et de différents compilateurs et outils du constructeur. Le README de DeepGEMM-Ascend demande explicitement CANN 9.20 et le compilateur Bisheng. Le changement concerne donc surtout la couche utilisée par les développeurs et les modèles, pas la disparition de l’écosystème Huawei situé en dessous.
Huawei essaie parallèlement d’ouvrir davantage cette couche. Lors de Huawei Connect en septembre, l’entreprise indiquait que CANN était désormais engagé dans un développement open source communautaire continu et détaillait également l’ouverture de plusieurs outils pour ses accélérateurs Ascend. Ce mouvement est important parce qu’une alternative matérielle crédible ne suffit pas si toute la pile nécessaire à son utilisation reste difficile d’accès ou totalement contrôlée par son constructeur.
Pourquoi l’Ascend 950 compte autant dans cette histoire
Les nouvelles bibliothèques ciblent surtout la génération Ascend 950, une famille de NPU que Huawei positionne précisément pour le calcul IA à grande échelle. Le constructeur avait annoncé des déclinaisons spécialisées selon les charges de travail, avec notamment l’Ascend 950DT orienté entraînement et décodage. Huawei met en avant davantage de formats numériques basse précision, une interconnexion à très haut débit et de grosses architectures SuperPoD destinées à faire fonctionner des milliers d’accélérateurs ensemble.
Mais le matériel n’est finalement que la moitié du produit. Nvidia a montré depuis longtemps qu’une puce extrêmement rapide devient beaucoup moins attirante si les développeurs doivent réécrire toutes leurs optimisations pour l’utiliser. En fournissant les bibliothèques utilisées réellement par ses propres modèles sur Ascend, DeepSeek donne à Huawei quelque chose que les fiches techniques ne peuvent pas fournir : du code de production servant de référence. Le dépôt DeepGEMM-Ascend remercie d’ailleurs explicitement Huawei pour son support technique et son expertise pendant le développement.
Ce n’est pas encore « installez PyTorch et oubliez votre GPU »
La prudence reste donc indispensable. Ces projets sont extrêmement récents et très orientés vers les besoins de DeepSeek. DeepEP-Ascend indique lui-même que ses mesures ont été réalisées sur un environnement Ascend 950DT précis et que le comportement sur d’autres générations Ascend ou d’autres versions de CANN n’est pas établi. Nous sommes encore loin d’un monde où l’on peut déplacer arbitrairement n’importe quel projet CUDA vers un NPU Huawei en modifiant simplement une ligne dans requirements.txt.
Même TileLang ne règle pas magiquement les différences entre architectures. Un kernel extrêmement optimisé dépend de la mémoire disponible, du nombre d’unités de calcul, des instructions vectorielles, de l’interconnexion et de dizaines de petits détails que le marketing appelle généralement « architecture propriétaire » et que l’ingénieur appelle « pourquoi ça plante uniquement avec cette taille de matrice ? ». Une abstraction multi-backend réduit le travail, mais le dernier kilomètre de performance restera toujours très dépendant du matériel.
Le vrai concurrent de CUDA pourrait finalement être… plusieurs backends
C’est là que cette annonce dépasse Huawei et DeepSeek. Pendant longtemps, la question semblait être : « qui fabriquera un CUDA concurrent ? » AMD possède ROCm, Huawei CANN, Intel ses outils, Apple Metal, tandis que chaque constructeur ajoute ses propres bibliothèques. Le résultat ressemble parfois à une réunion où chacun parle parfaitement sa langue mais où personne n’a pensé à inviter un interprète.
Des projets comme TileLang proposent une autre réponse : arrêter d’obliger l’application à choisir directement une seule pile matérielle. Le développeur écrit davantage de logique dans un langage commun et différents backends produisent les kernels spécialisés. Ce principe existe déjà ailleurs dans l’informatique GPU, mais son arrivée au cœur d’infrastructures réellement utilisées pour entraîner de très gros modèles lui donne une toute autre importance.
Pour Nvidia, le danger potentiel n’est donc pas nécessairement qu’un concurrent reproduise CUDA à l’identique. C’est que CUDA devienne progressivement un backend parmi plusieurs derrière des couches de programmation plus portables. Nvidia conserverait évidemment des avantages en performances, documentation, outils et maturité, mais une partie du verrouillage logiciel qui rend aujourd’hui un changement de fournisseur particulièrement douloureux pourrait diminuer.
L’open source devient aussi une arme de portabilité
Il y a enfin quelque chose d’assez ironique dans cette histoire. Les grands laboratoires IA pourraient parfaitement garder leurs kernels et bibliothèques ultra-optimisés en interne. DeepSeek choisit au contraire de publier une partie importante de cette plomberie sous licences ouvertes. DeepGEMM-Ascend est sous MIT, TileLang est développé publiquement et DeepEP-Ascend peut être étudié ou adapté par d’autres équipes.
Cela ne transforme évidemment pas Huawei ou DeepSeek en associations bénévoles de défense du logiciel libre. Une pile ouverte facilite l’adoption de leur technologie, attire des contributions et diminue la dépendance à un fournisseur concurrent. L’intérêt stratégique et l’intérêt de la communauté peuvent parfaitement exister au même endroit.
Et c’est probablement ce qui rend le mouvement intéressant.
Nvidia a construit pendant des années un écosystème où acheter un GPU facilite l’utilisation de CUDA, et où utiliser CUDA donne envie de continuer à acheter des GPU Nvidia. DeepSeek et Huawei tentent désormais d’attaquer cette boucle non pas uniquement avec davantage de silicium, mais en supprimant progressivement la partie la plus douloureuse du changement : le logiciel.
CUDA ne va évidemment pas disparaître parce que trois dépôts GitHub sont apparus un mercredi matin. Son écosystème reste immense, mature et profondément intégré à l’IA moderne.
Mais si demain le même kernel peut tourner sur Nvidia, AMD, Apple ou Huawei derrière une couche commune, la question ne sera peut-être plus :
« Est-ce que notre logiciel peut quitter CUDA ? »
Elle deviendra simplement :
« Quelle machine est disponible et combien coûte-t-elle ? »
Et là, la bataille des accélérateurs IA commencera à devenir beaucoup plus intéressante.
Sources & références
- DeepSeek — DeepGEMM-Ascend
- DeepSeek — DeepEP-Ascend
- TileLang — Dépôt officiel
- Reuters — DeepSeek partners with Huawei to develop chip programming tools
- Tom’s Hardware — DeepSeek and Huawei release open-source Ascend AI programming tools
- Huawei — Écosystème Ascend et CANN
- Huawei — Feuille de route Ascend 950 et SuperPoD
Communauté
Commentaires
Aucun commentaire pour le moment. Soyez le premier à réagir.