
À la une
KNOD : Linux veut transformer votre GPU en accélérateur réseau à 70 millions de paquets par seconde
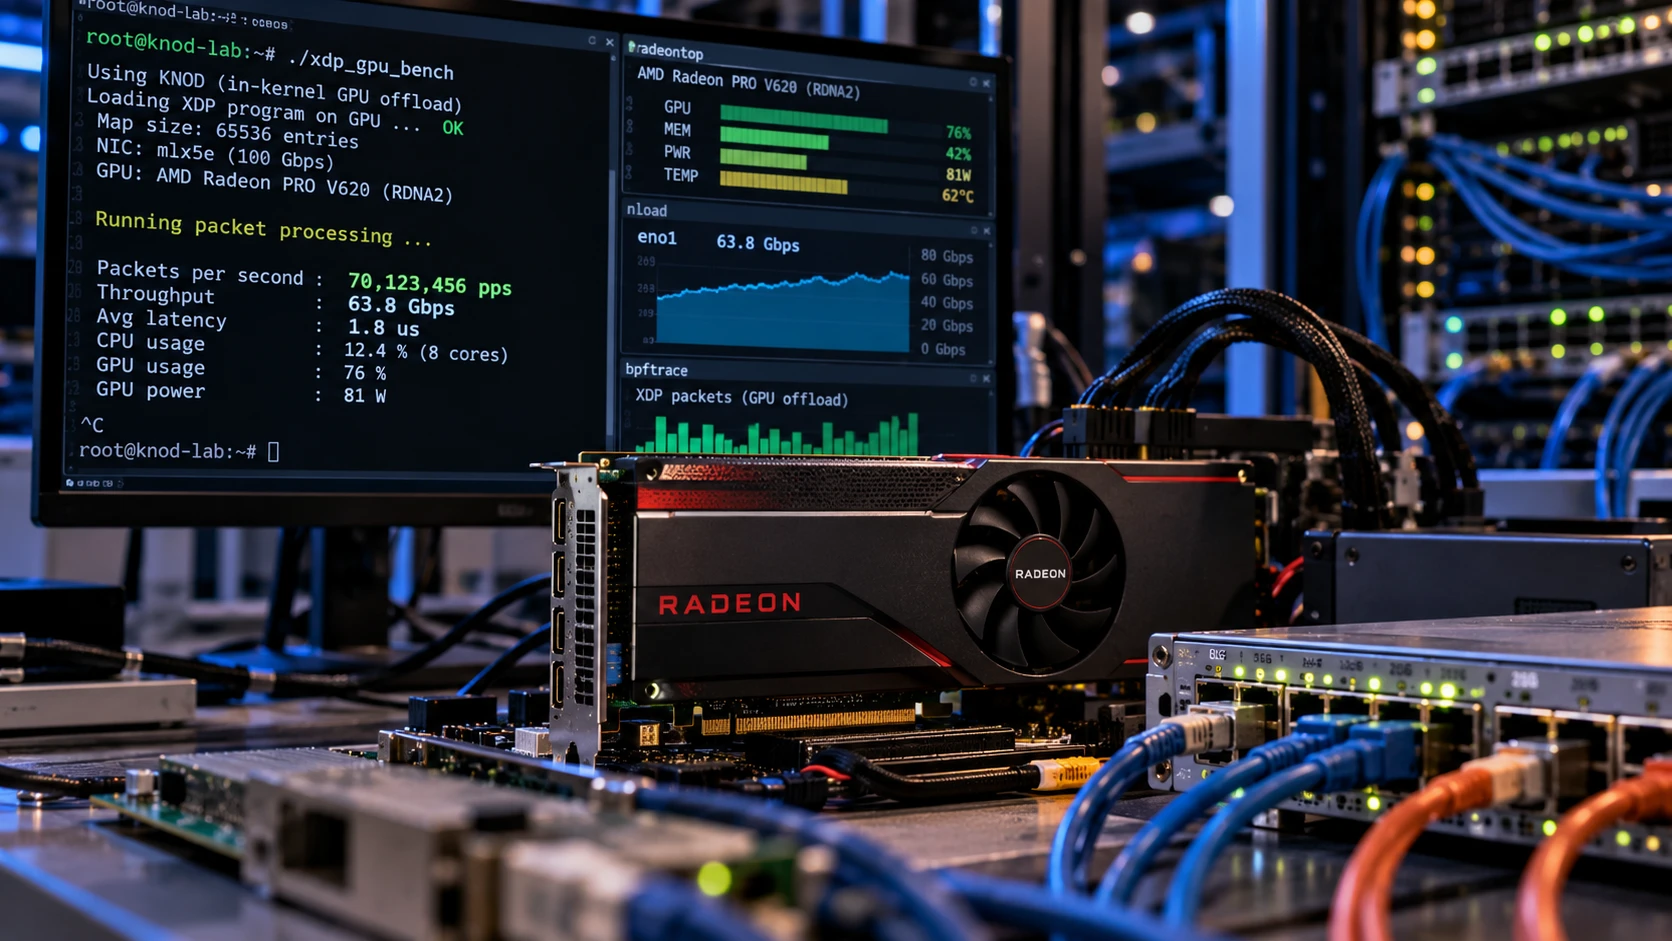
Et si votre carte graphique ne servait plus seulement à jouer, calculer de l’IA ou chauffer la pièce en hiver ? Présenté cette semaine à la Linux Plumbers Conference 2026, KNOD permet au noyau Linux d’envoyer directement certaines tâches réseau vers un GPU AMD. Les paquets arrivent depuis la carte réseau jusque dans une mémoire accessible au GPU, un programme XDP est compilé à la volée en code machine Radeon, puis des milliers de paquets peuvent être traités en parallèle. Jusqu’à 70 millions de paquets par seconde ont été mesurés sur une Radeon PRO V620. C’est encore un RFC expérimental, mais l’idée pourrait sérieusement rebattre les cartes du réseau haute performance.
Quand une Radeon commence à faire le boulot d’une carte réseau
Les GPU modernes sont des engins assez étranges. On les achète pour afficher des jeux, puis quelqu’un découvre qu’ils sont excellents pour miner des cryptomonnaies. Ensuite on les transforme en accélérateurs d’intelligence artificielle. Et maintenant, une équipe de développeurs Linux aimerait également leur confier… les paquets réseau.
Le projet s’appelle KNOD, pour in-Kernel Network Offload Device. Il a été présenté le 7 octobre par Hoyeon Lee de SUSE et Taehee Yoo de LINE Investment Technologies pendant la Linux Plumbers Conference 2026 , organisée à Prague.
Le concept paraît presque contre-nature au premier abord : au lieu de demander au processeur de gérer certaines opérations réseau, Linux les envoie directement vers le GPU.
Et pas en lançant un énorme programme CUDA ou ROCm dans un coin.
KNOD travaille directement depuis le noyau Linux, sans runtime GPU en espace utilisateur dans le chemin de données. Comme l’expliquent les développeurs dans leur présentation technique à la LPC 2026 , le noyau configure lui-même les files d’attente du GPU, compile le programme à exécuter et pilote le traitement.
Autrement dit, ce n’est pas « une application utilise la carte graphique pour accélérer du réseau ».
C’est Linux qui commence à considérer le GPU comme un véritable coprocesseur réseau.
XDP : intercepter le paquet avant qu’il ne visite tout Linux
Pour comprendre l’intérêt de KNOD, il faut parler rapidement de XDP, ou eXpress Data Path.
XDP permet d’exécuter de petits programmes eBPF extrêmement tôt lors de la réception d’un paquet réseau, avant que celui-ci ne traverse toute la pile réseau classique du noyau. Cela permet par exemple de filtrer un paquet, le rediriger, l’abandonner ou prendre une décision de load balancing avec beaucoup moins de travail qu’en le faisant remonter jusqu’à une application traditionnelle.
C’est notamment utilisé pour des pare-feu très rapides, de la protection DDoS, du routage ou des répartiteurs de charge.
Le problème est que le CPU doit toujours effectuer le calcul paquet après paquet. À très haut débit, cela finit donc par consommer beaucoup de cœurs.
KNOD prend le problème dans l’autre sens.
Un GPU possède énormément d’unités capables d’exécuter simultanément le même type d’opération sur de nombreuses données. Or traiter quelques dizaines de milliers de paquets qui demandent grosso modo la même série d’instructions correspond assez bien à ce genre d’architecture.
Dans leur RFC envoyé aux développeurs du noyau Linux , les auteurs expliquent justement que, là où un processeur doit multiplier les cœurs pour augmenter le nombre de paquets traités, un GPU peut appliquer parallèlement un petit programme à un volume énorme de paquets.
Pour une fois que le parallélisme massif du GPU sert à autre chose qu’à calculer la bonne manière de générer un chat astronaute en 4K.
Du câble Ethernet directement vers la mémoire du GPU
Le fonctionnement technique de KNOD est probablement la partie la plus intéressante du projet.
Dans l’architecture présentée par ses développeurs, la carte réseau peut placer les paquets reçus directement dans une zone mémoire accessible au GPU grâce au DMA. Linux récupère de son côté le programme XDP, puis KNOD effectue une compilation JIT vers le jeu d’instructions du GPU AMD.
Le GPU traite alors les paquets et renvoie les décisions XDP correspondantes.
Le chemin devient donc grossièrement :
carte réseau → mémoire GPU → programme XDP sur GPU → verdict réseau.
Il n’est plus nécessaire de rapatrier systématiquement les données dans la mémoire du CPU juste pour exécuter une opération qui sera répétée quelques millions de fois.
Le
patchset initial de KNOD
décrit notamment des pilotes capables de connecter les interfaces réseau Mellanox mlx5e et Broadcom bnxt_en au mécanisme d’offload. Côté GPU, l’implémentation passe par AMD KFD.
Le projet reste cependant conçu comme un framework plus général : son interface n’est pas censée rester éternellement collée à une seule carte AMD ou à une seule fonction réseau.
Et c’est là que l’histoire devient beaucoup plus intéressante qu’un simple benchmark.
Une Radeon RX 6600 à 32 millions de paquets par seconde
Parlons chiffres.
Les résultats publiés par les développeurs ont été obtenus sur des GPU AMD RDNA2, notamment une Radeon RX 6600 et une Radeon PRO V620.
Pour tester XDP, l’équipe utilise un répartiteur de charge dérivé de Katran, le load balancer open source initialement développé chez Meta.
D’après les benchmarks publiés dans le RFC de KNOD , une Radeon RX 6600 atteint jusqu’à 32 millions de paquets par seconde, avec une consommation GPU indiquée à 41 watts pendant ce test.
Sur une Radeon PRO V620, le résultat grimpe à 70 millions de paquets par seconde, pour environ 80 watts côté GPU.
Ce sont des mesures fournies par les développeurs du projet sur leur environnement de test, pas un comparatif indépendant effectué sur une batterie de serveurs identiques. Il faut donc les prendre pour ce qu’elles sont : une démonstration de faisabilité et de performances potentielles.
Mais 70 millions de paquets par seconde sur un GPU qui n’a pas été conçu comme une carte réseau spécialisée reste suffisamment inhabituel pour attirer l’attention.
Les auteurs expliquent également que le déport réduit logiquement la charge CPU correspondant au programme XDP, même si KNOD lui-même ajoute un léger coût de gestion, comme le montre également l’analyse technique du patchset relayée par LWN .
En résumé, le processeur peut retourner s’occuper de choses plus dignes de lui.
Comme ouvrir 74 onglets Electron.
Et tant qu’à avoir un GPU : déchiffrons aussi de l’IPsec
L’équipe ne s’est pas arrêtée à XDP.
KNOD possède également une preuve de concept permettant de déporter sur le GPU le déchiffrement IPsec ESP des paquets reçus.
Les mesures communiquées par les développeurs atteignent 80 Gbit/s sur RX 6600 comme sur Radeon PRO V620.
Mais ici, prudence : les développeurs précisent explicitement que cette implémentation IPsec est un proof of concept, et non quelque chose que l’on devrait installer demain matin sur le routeur d’un datacenter bancaire.
Elle ne concerne actuellement que le trafic reçu, pas l’émission, et sert surtout à démontrer qu’une infrastructure initialement pensée autour de XDP peut prendre en charge d’autres opérations réseau accélérées.
Cette distinction est importante, parce que KNOD n’est justement pas présenté comme « un accélérateur XDP AMD ».
L’idée serait plutôt d’avoir une couche générique permettant au noyau Linux de connecter un périphérique réseau à différents accélérateurs.
Aujourd’hui un GPU.
Demain peut-être autre chose.
Pas de CUDA, pas de ROCm, et c’est justement le truc intéressant
L’un des aspects les plus surprenants de KNOD est précisément ce qu’il n’utilise pas.
Pas besoin d’un runtime CUDA. Pas besoin de ROCm en espace utilisateur dans le data path.
Le projet programme directement le matériel à travers les composants du noyau nécessaires.
C’est une différence fondamentale par rapport aux applications GPU habituelles, dans lesquelles un logiciel utilisateur envoie des calculs à une API spécialisée.
Ici, la carte graphique devient un périphérique piloté par le noyau pour effectuer une tâche système.
La présentation officielle de KNOD à la Linux Plumbers Conference précise que le projet sait désormais gérer les branchements divergents dans les programmes BPF déportés, prend en charge RDNA2 et a bénéficié de plusieurs optimisations concernant le batching, l’occupation du GPU et les transferts mémoire.
Le développement avait commencé avec les architectures AMD GCN, notamment une Vega 64, mais le chemin de données actuel dépend d’opérations atomiques 64 bits absentes sur cette génération. Les développements et benchmarks récents ciblent donc principalement RDNA2.
Le futur pourrait toutefois dépasser AMD.
Après la présentation de Prague, Phoronix rapporte que les développeurs souhaitent explorer Intel Arc , les GPU intégrés AMD ainsi qu’une compatibilité plus large avec différentes cartes réseau Intel et Broadcom.
Est-ce qu’on va bientôt installer une Radeon dans son routeur ?
Probablement pas.
Du moins pas encore.
KNOD est actuellement un RFC, autrement dit une proposition soumise à discussion et à revue par les développeurs du noyau. Le code n’est pas intégré à Linux mainline et rien ne garantit que l’architecture actuelle sera acceptée telle quelle.
Le projet soulève d’ailleurs des questions assez sérieuses : où doit se situer la frontière entre les sous-systèmes réseau, BPF, DRM et les pilotes d’accélérateurs ? Comment gérer correctement les files liées aux CPU lorsqu’un GPU se trouve de l’autre côté ? Comment intégrer le contrôle de tout cela aux outils réseau Linux existants ?
Ces sujets font explicitement partie des problèmes encore ouverts présentés à la LPC 2026 .
Le code de développement est néanmoins public dans le dépôt GitHub de KNOD , actuellement basé sur une branche modifiée du noyau Linux.
Nous sommes donc clairement dans la catégorie « développeurs kernel et personnes dont le homelab dispose curieusement d’une baie réseau 100 GbE », pas dans celle du tutoriel du dimanche après-midi.
Pourquoi ne pas simplement utiliser une SmartNIC ?
C’est évidemment la question qui vient ensuite.
Les centres de données disposent déjà de cartes spécialisées capables d’effectuer du filtrage, de la cryptographie, du routage ou du traitement eBPF directement sur le matériel réseau. On parle notamment de SmartNIC, de DPU ou d’autres accélérateurs dédiés.
Mais KNOD explore une idée différente : réutiliser un accélérateur généraliste déjà présent dans la machine.
Un GPU moderne possède une puissance parallèle considérable et peut être beaucoup plus flexible qu'un circuit conçu pour un ensemble bien précis de tâches réseau.
Cela ne signifie pas qu’une Radeon va remplacer une DPU dans tous les serveurs. Les contraintes de latence, de consommation, de sécurité, de partage des ressources et de prévisibilité ne sont absolument pas les mêmes.
En revanche, pour certaines charges de travail où un GPU est déjà disponible, la question devient intéressante : pourquoi réserver des centaines ou des milliers d’unités de calcul à l’affichage ou à l’IA si le système peut également les mobiliser ponctuellement pour absorber un énorme volume de trafic ?
C’est précisément ce que KNOD commence à expérimenter.
Linux transforme doucement le PC en collection de coprocesseurs
Ce projet illustre également une évolution plus générale du matériel moderne.
Pendant longtemps, la machine ressemblait essentiellement à un gros processeur entouré de périphériques.
Aujourd’hui, elle contient un CPU, un GPU, parfois un NPU, des moteurs vidéo, des accélérateurs cryptographiques et diverses unités spécialisées possédant chacune leur propre mémoire et leur propre capacité de calcul.
Le vrai problème devient donc moins « comment rendre le CPU plus rapide ? » que « comment faire travailler intelligemment tout ce petit monde ensemble ? ».
KNOD pousse cette logique jusque dans le réseau.
L’idée reste expérimentale, plusieurs problèmes d’architecture doivent encore être résolus et les performances publiées doivent être confirmées sur davantage de matériel. Mais le concept est suffisamment élégant pour mériter d’être suivi.
Une Radeon capable d’exécuter un programme XDP directement depuis le noyau Linux n’était probablement pas la fonction prévue sur la boîte.
Mais après les jeux vidéo, le minage, Blender, Folding@home et les modèles de langage, les GPU ont visiblement décidé qu’ils pouvaient aussi devenir cartes réseau.
À ce stade, il ne leur manque plus qu’une cafetière USB et on pourra supprimer le processeur.
Communauté
Commentaires
Aucun commentaire pour le moment. Soyez le premier à réagir.