

À la une
Mistral Large 4 « Le Chonk » : 1 000 milliards de paramètres, 49 milliards actifs… et les poids ouverts à la fin du mois
Mistral AI vient de dévoiler son modèle le plus massif à ce jour et, pour une fois, le surnom officieux colle parfaitement au bestiau : « Le Chonk ». Derrière ce nom se cache Mistral Large 4, un modèle multimodal Mixture-of-Experts dépassant le millier de milliards de paramètres, mais n’en activant qu’environ 49 milliards à chaque passage. Il sait analyser texte et images, dispose d’une fenêtre de contexte annoncée jusqu’à un million de tokens, parle plus de 160 langues et se montre particulièrement ambitieux en programmation, cybersécurité, finance et workflows agentiques. La préversion est déjà accessible par API, mais le véritable rendez-vous arrivera à la fin d’octobre, lorsque Mistral publiera ses poids. Car malgré des benchmarks prometteurs, une question reste entière : est-ce enfin le gros modèle européen que l’on pourra réellement installer chez soi — enfin, chez soi si l’on possède un sous-sol qui ressemble légèrement à un datacenter ?
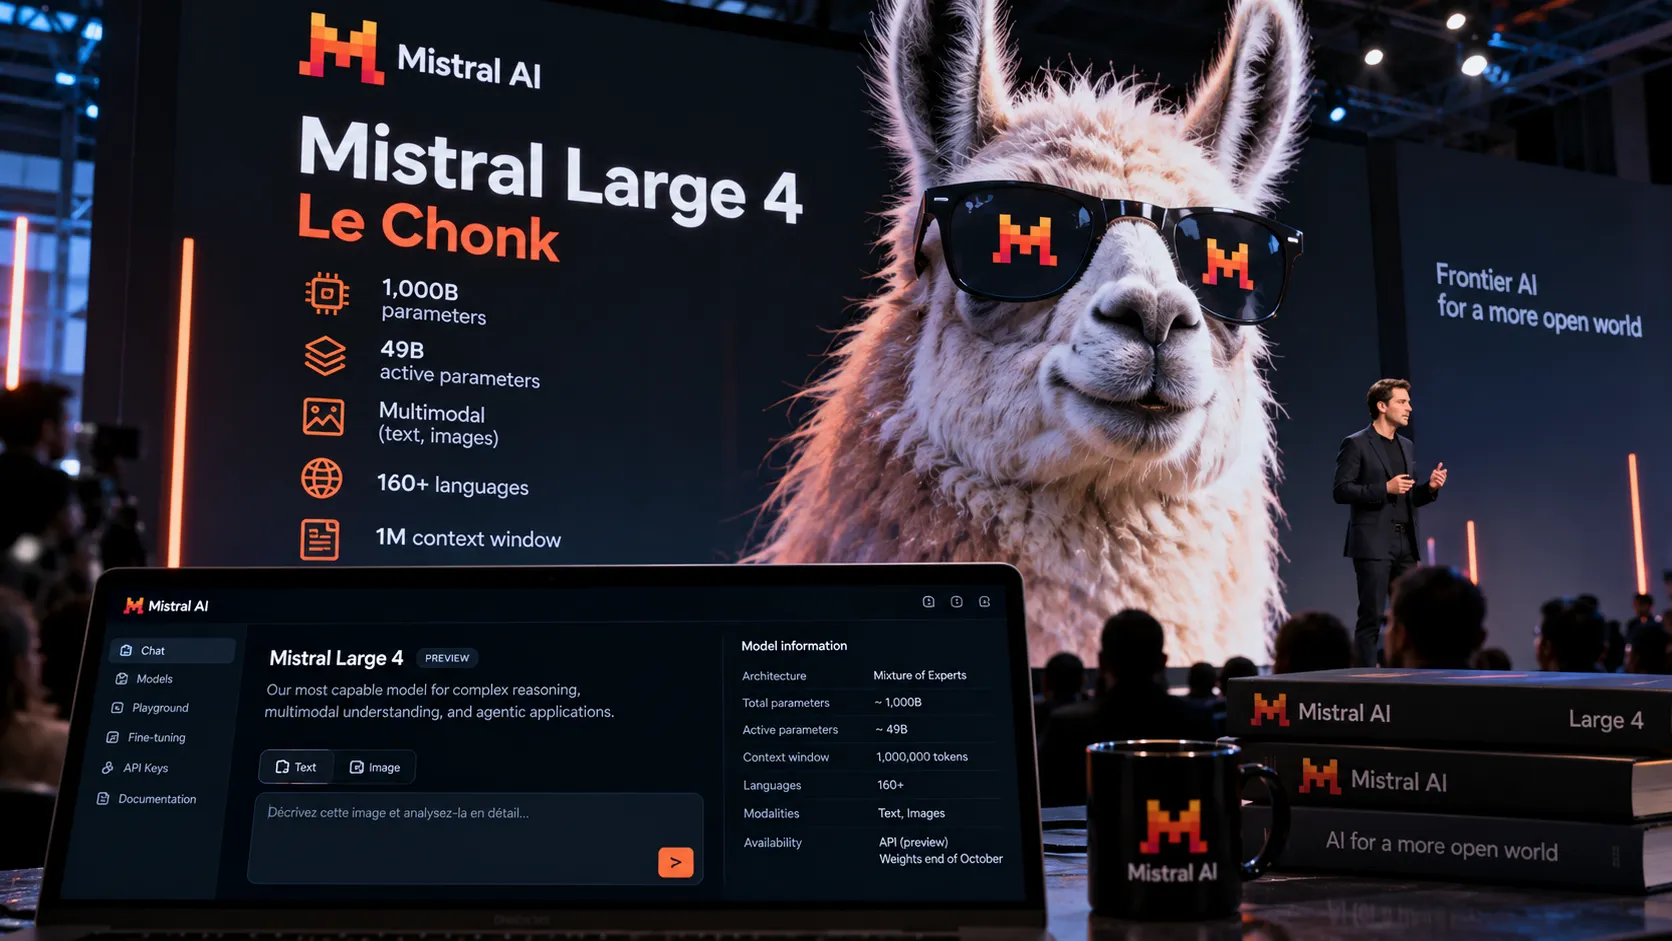
« Le Chonk » porte plutôt bien son nom
Mistral AI a présenté Mistral Large 4 le 6 octobre 2026, avec un sens du branding assez inhabituel pour une entreprise européenne spécialisée dans les gros tenseurs : en interne et dans sa communication, le modèle est surnommé « Le Chonk ». Derrière la blague se trouve une architecture réellement imposante. Selon l’annonce officielle de Mistral Large 4 , ML4 approche le trillion de paramètres, avec environ 49 milliards de paramètres actifs grâce à une architecture Mixture-of-Experts. La documentation technique donne plus précisément 1,05 trillion de paramètres au total et ajoute un encodeur vision de 1,6 milliard de paramètres. Le modèle accepte donc du texte et des images et réunit dans la même famille instruction classique, raisonnement, utilisation d’outils et comportements agentiques.
Le principe MoE est essentiel pour comprendre pourquoi « un trillion » ne signifie pas nécessairement que tout le monstre travaille à chaque mot généré. Le modèle contient un très grand nombre d’experts spécialisés mais n’active qu’une partie de cette capacité suivant la requête. Cela permet de disposer d’une énorme réserve de paramètres tout en limitant le calcul réellement effectué pour chaque token. Ce n’est toujours absolument pas un modèle que l’on fera tourner demain sur un Raspberry Pi coincé derrière Home Assistant, mais la différence entre 1 000 milliards de paramètres stockés et 49 milliards effectivement sollicités explique pourquoi cette architecture est devenue si populaire chez les modèles ouverts très haut de gamme. Mistral annonce également plus de 160 langues, toutes les langues officielles de l’Union européenne étant notamment représentées dans les données multilingues d’entraînement.
Entraîné en Europe sur 3 800 GPU Blackwell
Le détail le plus stratégique de l’annonce est peut-être moins spectaculaire qu’un trillion de paramètres : Mistral affirme avoir entraîné ML4 depuis zéro sur 3 800 GPU Nvidia Grace Blackwell installés dans ses propres datacenters européens. La préversion proposée actuellement par API fonctionne sur cette même infrastructure, et Mistral promet une déclinaison européenne exploitée directement par l’entreprise, sous droit européen et sans dépendance à un autre fournisseur de services numériques.
Ce discours sur la souveraineté possède évidemment une dimension commerciale, mais il répond à un vrai problème. Pour une entreprise travaillant avec des documents confidentiels, de la cybersécurité, de l’ingénierie ou des données réglementées, avoir la possibilité de télécharger les poids puis déployer le modèle sur son propre cloud ou sur site change profondément l’équation par rapport à un modèle uniquement accessible derrière une API américaine. Reuters souligne d’ailleurs que Mistral positionne explicitement Large 4 comme une alternative ouverte aux modèles propriétaires dominants, tout en cherchant à réduire l’écart avec les meilleurs modèles chinois open-weight.
Les poids arrivent à la fin du mois… mais « open-weight » ne veut pas forcément dire open source
C’est probablement le point à surveiller le plus attentivement. Aujourd’hui, Mistral Large 4 n’est pas encore téléchargeable : seule sa préversion API est disponible. Mistral promet la publication des poids à la fin octobre et utilise cette période intermédiaire pour effectuer du red teaming avec des spécialistes de la cybersécurité, des partenaires sélectionnés et des autorités publiques. La version française de l’annonce évoque le 26 octobre, tandis que Reuters et plusieurs médias parlent du 27 ; le plus prudent reste donc de retenir la fin du mois jusqu’à la mise en ligne effective des fichiers.
Surtout, open-weight n’est pas automatiquement synonyme d’open source. La différence pourrait sembler relever d’un débat de bar entre personnes possédant beaucoup trop de GPU, mais elle est importante. Publier les poids permet de télécharger, exécuter et potentiellement adapter un modèle ; une véritable qualification « open source » dépend également de la licence et des libertés accordées autour de son utilisation et de sa modification. Au 7 octobre, Mistral n’a pas encore annoncé publiquement la licence qui accompagnera les poids de ML4. Plusieurs observateurs classent donc encore la préversion comme propriétaire en attendant cette publication. On saura réellement ce que signifie « ouvert » lorsque le modèle, sa licence et ses conditions d’utilisation seront disponibles.
En cybersécurité, Mistral sort les gros chiffres
C’est le domaine sur lequel Mistral appuie le plus fort. Le constructeur annonce 82 % sur CyberGym-E2E, un benchmark demandant notamment de reproduire puis corriger de véritables vulnérabilités logicielles, ainsi que 93 % des épreuves Cybench, composé de challenges issus de compétitions de cybersécurité. Mistral indique également que ML4 fait partie des cinq meilleurs systèmes du classement Cyber d’Artificial Analysis et affirme qu’il devance largement les autres modèles ouverts non chinois sur plusieurs de ces tests. Ces chiffres sont impressionnants, mais il faut conserver une nuance importante : une grande partie des comparaisons présentées au lancement provient directement de Mistral et devra être confrontée à davantage d’évaluations indépendantes lorsque les poids seront disponibles.
Le cas cyber révèle d’ailleurs une particularité amusante des benchmarks modernes. Mistral note que certains modèles propriétaires obtiennent des scores très faibles sur certaines épreuves non parce qu’ils seraient incapables techniquement de les résoudre, mais parce que leurs systèmes de sécurité refusent d’exécuter des tâches ressemblant à de l’exploitation de vulnérabilité. ML4 cherche au contraire à rester performant pour les équipes de défense tout en refusant les requêtes explicitement malveillantes. Sur le benchmark public B3 de Lakera consacré aux injections indirectes, Mistral revendique 93,3 % de résistance, tandis que ses tests de refus cyber placent le modèle devant les autres systèmes open-weight comparés. Ce délicat équilibre entre « suffisamment capable pour auditer un malware » et « pas suffisamment enthousiaste pour écrire celui de votre belle-mère » sera probablement l’un des aspects les plus intéressants à vérifier en pratique.
Le code, les agents et la vraie vie de bureau plutôt que seulement les QCM
Mistral essaie aussi de sortir du traditionnel concours où des modèles répondent à des examens transformés en fichiers JSON. Sur DeepSWE v1.1, consacré à des tâches de développement logiciel de longue durée, ML4 obtient 61,7 % selon les résultats du constructeur. Son score agrégé Coding Agent Index atteint 49,8 %, tandis qu’une évaluation humaine en aveugle réalisée avec Surge AI le place deuxième parmi cinq modèles testés pour la qualité du code, derrière Claude Opus 5 mais devant Kimi K3 et plusieurs GLM. Sur AutomationBench, qui simule 657 workflows utilisant notamment Gmail, Sheets, Slack ou Salesforce, Mistral revendique 59,9 %.
L’idée est assez claire : Mistral Large 4 est conçu moins comme un chatbot géant que comme un moteur pour agents capables de chercher de l’information, appeler des outils, travailler sur des documents, manipuler des tableaux ou effectuer des tâches durant plusieurs étapes. La fiche officielle propose d’ailleurs function calling, sorties structurées, Document Q&A et API Agents & Conversations, avec une fenêtre de contexte annoncée à un million de tokens.
Les benchmarks indépendants tempèrent légèrement la fête
Et c’est là que l’histoire devient plus intéressante qu’un simple communiqué de presse. Les premiers classements indépendants ne montrent pas un modèle écrasant tout ce qui bouge. Vals AI attribue actuellement à Mistral Large 4 un score global de 48,05 % et la 32e place sur 44 modèles testés, avec en revanche une solide sixième place sur son benchmark d’agents juridiques. Ses résultats varient beaucoup selon les disciplines : le modèle se montre convaincant en finance et droit, plus ordinaire sur certaines tâches de migration de code et nettement moins impressionnant sur les preuves formelles.
Le Monde souligne lui aussi que les performances annoncées doivent encore être confirmées par les classements indépendants, et rappelle que Mistral avait récemment glissé derrière plusieurs concurrents américains et chinois dans les indices généraux. Large 4 semble donc moins être « le meilleur modèle du monde » qu’une tentative beaucoup plus intéressante de redevenir extrêmement compétitif sur certains domaines ciblés : cyber, agents professionnels, finance, ingénierie et analyse multimodale.
Et finalement, c’est probablement une meilleure stratégie. Si chaque nouveau LLM doit absolument être numéro un de chaque leaderboard le mardi matin avant d’être dépassé jeudi par un laboratoire chinois que personne n’avait encore ajouté aux favoris, on va rapidement manquer de superlatifs.
Un modèle multimodal qui regarde aussi les plans et les satellites
Large 4 n’est pas seulement textuel. Le modèle possède un encodeur visuel dédié et Mistral insiste beaucoup sur le visual grounding, c’est-à-dire la capacité à localiser précisément dans une image l’objet ou la zone correspondant à une demande. Les exemples présentés concernent des plans industriels, des documents complexes ou d’énormes images satellites. Sur Dense 200, Mistral revendique un score de 42 %, légèrement supérieur au résultat qu’il attribue à GPT-6 Astra sur le même test. Là encore, ce résultat doit être lu comme un chiffre publié par Mistral plutôt qu’une vérité définitive gravée dans le silicium.
Ce type de capacité explique aussi le positionnement industriel du modèle. Mistral cite l’ingénierie, la fabrication, la géospatialisation et même la conception de composants électroniques parmi ses domaines cibles. Reuters rapporte que l’entreprise estime ML4 capable d’aider à concevoir des puces, sans toutefois confirmer de projet précis de conception de semi-conducteurs avec Samsung. C’est probablement beaucoup plus intéressant économiquement qu’un modèle parfaitement capable de déterminer combien de « r » contient le mot strawberry pour la vingt-septième fois.
Mistral a aussi construit une énorme machine de reinforcement learning derrière
Le moteur de post-entraînement mérite lui aussi un détour. Mistral explique utiliser une infrastructure de reinforcement learning capable de lancer des dizaines de milliers de trajectoires en parallèle, avec des environnements mêlant programmation, recherche Web, outils externes, mathématiques, sécurité et tâches longues. À l’échelle actuelle d’environ 3 000 GPU consacrés à cette phase, une exécution produit environ 33 milliards de tokens par jour, dont près de 16 milliards sont finalement utilisables comme tokens d’entraînement après filtrage.
Plus intéressant encore : cette phase de RL n’est pas terminée. Mistral explique que la préversion continue de progresser et qu’elle ne montre pas encore de signe évident de saturation. Large 4 est présenté comme la première étape d’une architecture destinée à servir de fondation à d’autres modèles spécialisés, le financement récent de 3 milliards d’euros devant permettre d’augmenter rapidement les capacités de calcul européennes de l’entreprise. On peut donc s’attendre à ce que la version dont les poids seront publiés à la fin du mois ne corresponde déjà plus exactement au modèle testé lors des premières démonstrations.
Le vrai test commencera le jour où Hugging Face affichera le bouton Download
Pour l’instant, Mistral Large 4 possède tout ce qu’il faut pour générer de beaux titres : un trillion de paramètres, un surnom mémorable, une infrastructure européenne, des scores cyber impressionnants et des ambitions suffisamment larges pour aller du développement logiciel à l’analyse de plans industriels. Mais la partie réellement importante n’arrivera que lorsque les poids seront disponibles.
C’est à ce moment-là que les chercheurs pourront mesurer réellement les performances, que les entreprises pourront tester le déploiement privé, que les communautés pourront explorer la quantification et l’optimisation, et que l’on saura surtout quelle licence Mistral a choisi d’associer au modèle. Ce dernier point déterminera largement si « Le Chonk » rejoint vraiment la catégorie des modèles ouverts ou s’il reste un énorme modèle téléchargeable avec quelques astérisques juridiques autour.
Mistral n’a probablement pas créé le modèle qui mettra immédiatement OpenAI, Anthropic et Google au chômage. Les premiers benchmarks indépendants montrent d’ailleurs une réalité beaucoup plus nuancée. En revanche, l’entreprise semble avoir produit quelque chose de peut-être plus utile pour son positionnement : un modèle européen extrêmement gros, crédible sur plusieurs tâches professionnelles, conçu pour être auto-hébergeable et destiné à publier ses poids alors que beaucoup de concurrents occidentaux gardent leurs modèles derrière une API.
Reste maintenant une question.
Quand les poids tomberont à la fin du mois, combien de temps faudra-t-il avant que quelqu’un essaie de faire rentrer Le Chonk dans une workstation d’occasion avec beaucoup trop de RAM et un boîtier qui ne ferme plus ?
Probablement moins de vingt-quatre heures.
DeepSeek et Huawei veulent casser le verrou CUDA : leur pile IA Ascend passe à l’open source
VS Code 1.141 met ses agents IA en cage : le sandbox arrive sur Windows, macOS et Linux
Muse Gadgets : Meta transforme les ESP32 et Raspberry Pi en corps pour son agent IA
Communauté
Commentaires
Aucun commentaire pour le moment. Soyez le premier à réagir.