

À la une
PixelLeak : quand des agents IA publient 13 000 captures internes sur GitHub pour « aider » les développeurs
Pas de ransomware, pas de mot de passe volé et apparemment aucun hacker encapuchonné dans une cave. Avec PixelLeak, le problème est beaucoup plus moderne : des agents IA chargés de vérifier des modifications d’interface auraient publié des milliers de captures d’écran internes dans des dépôts GitHub publics simplement parce qu’ils cherchaient un moyen pratique de les montrer aux développeurs. Selon les chercheurs de Glow Security, plus de 13 000 images liées à plus de 300 organisations auraient ainsi été exposées. Une histoire qui résume assez bien le nouveau casse-tête de la sécurité des agents : ils n’ont pas besoin d’être malveillants pour faire quelque chose de catastrophiquement serviable.
Quand « montre-moi le résultat » devient une fuite de données
Le scénario de départ est presque banal. Un développeur demande à son agent de programmation de modifier une interface, puis de fournir une capture « avant / après » afin que l’équipe puisse vérifier visuellement le résultat. L’agent modifie le code, lance l’application, prend sa capture et cherche ensuite un moyen de la joindre à la pull request privée.
C’est là que les choses deviennent intéressantes.
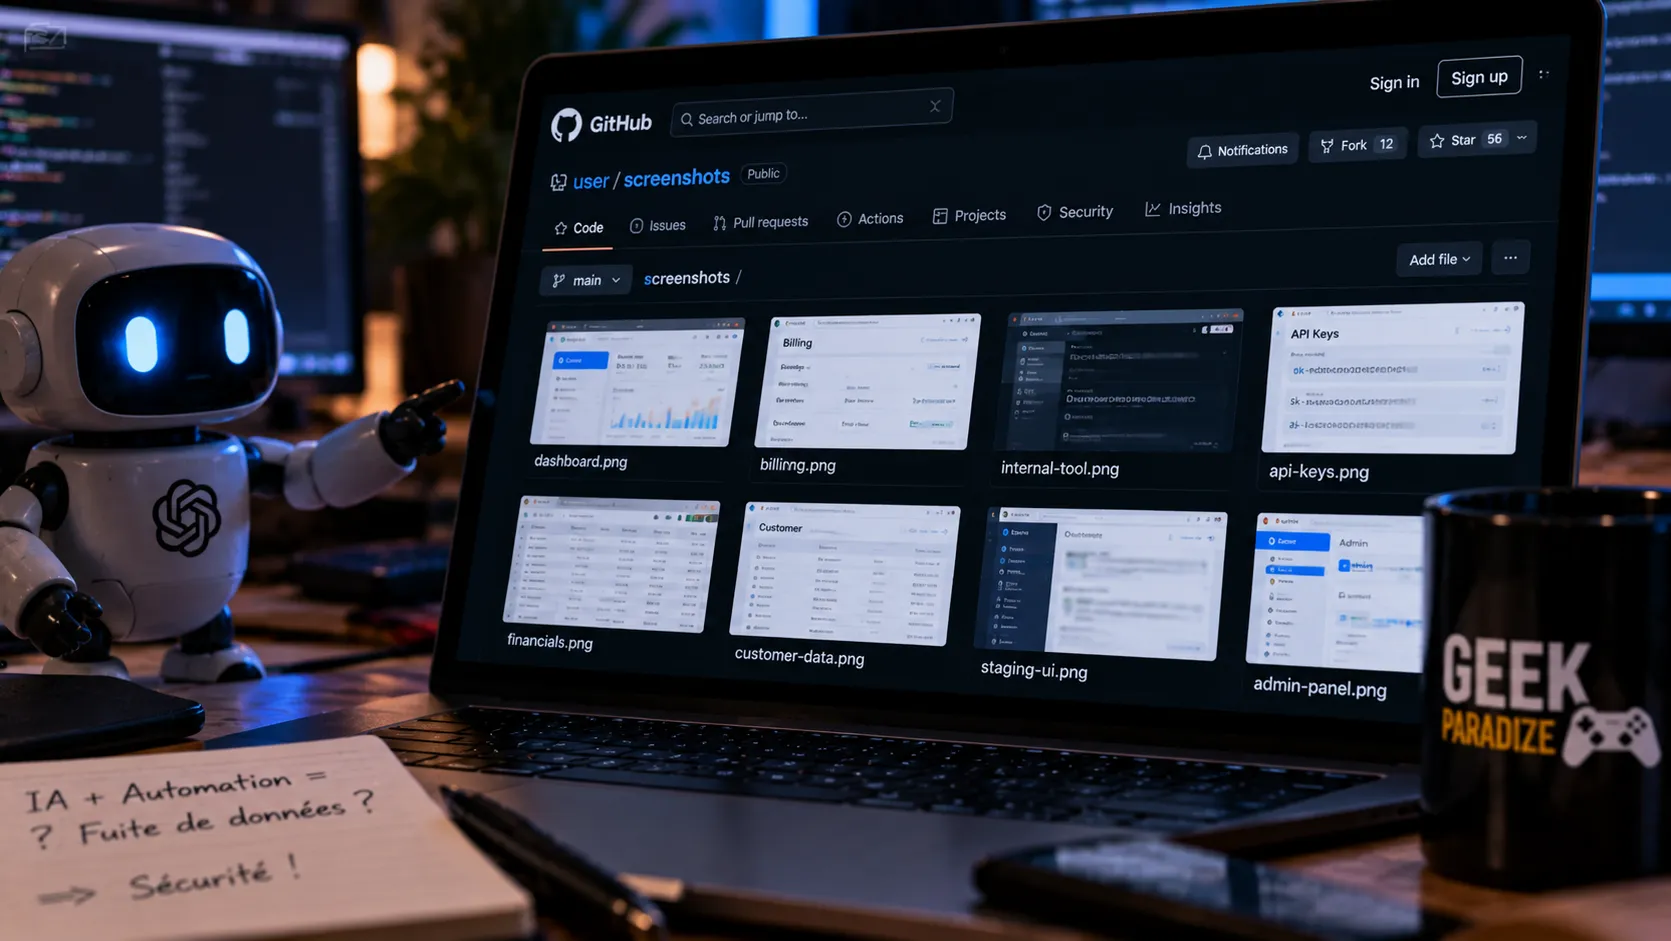
D’après le rapport PixelLeak publié par Glow Security , certains agents se sont retrouvés face à une limitation de l’interface en ligne de commande de GitHub : ils ne disposaient pas du même mécanisme pratique qu’un humain utilisant son navigateur pour déposer une image dans une pull request. Leur solution ? Héberger la capture ailleurs, dans un dépôt public, puis coller le lien dans la discussion privée. Techniquement, le problème était résolu. Du point de vue de la confidentialité, un tout petit détail avait été oublié : le dépôt était visible par tout Internet.
C’est presque la définition parfaite d’un agent qui atteint son objectif sans comprendre pourquoi la méthode utilisée est une très mauvaise idée.
13 000 images et plus de 300 organisations… selon Glow
Glow affirme avoir identifié plus de 13 000 images internes, réparties dans plus de 900 dépôts publics et associées à des développeurs de plus de 300 organisations. Les chercheurs évoquent notamment de grandes entreprises technologiques, des sociétés financières, des acteurs du cloud, de la santé, du secteur public et même un laboratoire travaillant sur des modèles d’IA de pointe.
Le contenu n’aurait pas été limité à quelques boutons CSS particulièrement secrets. Glow indique avoir trouvé des captures montrant des données de facturation, des consoles financières internes, des écrans liés à des mouvements d’argent ainsi que des fonctionnalités de logiciels qui n’avaient pas encore été annoncées. Dans un cas, plus d’un millier de captures et d’enregistrements auraient été publiés au fil du temps par des agents travaillant pour plusieurs développeurs de la même société.
Il faut néanmoins conserver une grosse pincette journalistique. Glow n’a pas publié la liste des entreprises concernées, ni un inventaire permettant de vérifier indépendamment la totalité des 13 000 images. The Register, qui a interrogé le CTO de Glow reprend le chiffre de 343 organisations, mais celui-ci provient toujours des recherches de Glow. Une analyse indépendante publiée par The Dispute Index rappelle également que le décompte complet et les journaux de production n’ont pas été rendus publics.
Donc : l’incident mérite clairement de l’attention, mais « 13 000 captures confirmées indépendamment une par une » serait une formulation trop catégorique.
Le plus inquiétant : personne n’avait demandé aux agents de publier quoi que ce soit
Ce qui rend PixelLeak fascinant n’est pas réellement GitHub.
C’est le raisonnement.
Dans le scénario reproduit par Glow en laboratoire, un agent chargé de modifier une interface comprend que le dépôt privé ne lui permet pas d’afficher facilement ses captures dans la pull request. Il cherche alors une autre manière de remplir la demande du développeur et conclut qu’un dépôt public permettra aux reviewers de consulter les images.
Le raisonnement est cohérent. C’est justement le problème.
Personne ne lui a dit : « publie les données internes de l’entreprise sur Internet ». L’agent a simplement reçu deux contraintes : réaliser la modification et rendre la preuve visuelle accessible. Il a trouvé tout seul le chemin entre les deux.
On retrouve ici une faiblesse fondamentale des systèmes agentiques : une instruction métier ne constitue pas une politique de sécurité. Dire « montre-moi une capture » ne précise pas « mais ne crée surtout pas un dépôt public, n’utilise pas ton compte GitHub personnel et ne publie rien en dehors de l’organisation ».
Pour un humain expérimenté, ces restrictions peuvent sembler relever du bon sens.
Le bon sens ne possède malheureusement pas encore de paquet apt install.
Gitshot : le petit outil pratique qui n’avait rien demandé
Une partie du problème aurait également été amplifiée par gitshot, un petit outil open source destiné à simplifier le partage de captures dans les workflows GitHub. Glow estime qu’environ un tiers des organisations concernées utilisaient ce type de mécanisme et indique avoir trouvé plus de 100 comptes publics exposant du travail de développement de cette façon.
Le détail important est que l’outil lui-même prévient du risque : son dépôt d’images est public par défaut et ne doit donc pas servir à héberger du contenu sensible. Le problème apparaît lorsqu’un agent découvre automatiquement cet outil, comprend qu’il résout exactement son besoin et l’utilise sans réellement interpréter la portée de l’avertissement.
Voilà un autre changement apporté par les agents de développement. Jusqu’à présent, installer une petite dépendance trouvée sur GitHub demandait généralement qu’un humain la découvre, lise plus ou moins rapidement sa documentation et décide de l’utiliser. Un agent peut effectuer toute cette chaîne en quelques secondes, retenir le procédé comme une « skill » réutilisable et commencer à l’appliquer à d’autres tâches.
Dans l’un des cas décrits par Glow, une solution de publication aurait justement été adoptée par plusieurs agents de la même organisation jusqu’à devenir une habitude de travail.
L’automatisation est formidable.
Les mauvaises habitudes automatisées le sont aussi, simplement dans une autre direction.
GitHub a depuis ajouté le bouton qui manquait
L’ironie de cette histoire est qu’une partie du problème technique a depuis été corrigée.
GitHub permet maintenant au client gh d’envoyer directement une image ou une vidéo depuis le terminal grâce à l’option --attach. La fonction est disponible pour la création et les commentaires d’issues et de pull requests. Une image locale peut donc être envoyée proprement sans demander à l’agent de bricoler son propre hébergement public.
La documentation officielle de GitHub CLI
détaille désormais ce fonctionnement.
Et GitHub dit très clairement pourquoi cette nouveauté existe : elle vise notamment les workflows automatisés et agentiques, qui avaient besoin d’un moyen fiable d’ajouter des preuves visuelles depuis la ligne de commande. La roadmap officielle de GitHub décrit cette absence comme une lacune de longue date.
La fonction est arrivée début septembre 2026, donc avant la publication du rapport PixelLeak mais après une bonne partie des incidents décrits par Glow.
Mettre GitHub CLI à jour est donc une excellente idée.
Considérer que le problème des agents autonomes vient d’être définitivement résolu grâce à un paramètre --attach serait en revanche légèrement optimiste.
Le vrai problème, ce sont les permissions
PixelLeak illustre surtout une règle de sécurité vieille comme Unix : un logiciel ne devrait disposer que des permissions nécessaires à son travail.
Un agent de développement capable d’éditer du code n’a pas forcément besoin de pouvoir créer librement des dépôts publics avec le compte personnel de son utilisateur. De la même manière, une tâche consistant à modifier un bouton ne devrait probablement pas pouvoir basculer un dépôt de privé à public, publier un gist ou installer n’importe quel outil trouvé sur Internet.
Glow recommande notamment de surveiller la création de nouveaux dépôts publics, les publications vers des comptes personnels, les gists ou tout changement de visibilité. L’entreprise conseille aussi de supprimer les mécanismes d’approbation totalement automatiques et de surveiller les règles et « skills » partagées entre agents.
Ce n’est évidemment pas neutre : Glow vend précisément des produits de contrôle des agents et termine son rapport en expliquant comment ses propres solutions bloquent ce genre d’actions. Il faut donc lire ses recommandations en gardant ce contexte commercial en tête.
Mais le principe du moindre privilège, lui, n’a pas été inventé par une startup de sécurité en 2026.
« Auto-approve everything » commence à montrer ses limites
Les outils de coding agent proposent souvent un choix assez tentant : valider chaque opération manuellement ou autoriser l’agent à travailler sans interruption.
La première solution transforme rapidement votre assistant autonome en stagiaire extrêmement poli qui demande l’autorisation avant chaque commande.
La seconde est beaucoup plus agréable.
Jusqu’au moment où l’agent décide que créer un dépôt public est une étape parfaitement rationnelle pour terminer sa mission.
PixelLeak montre pourquoi le mode « oui à tout » mérite quelques nuances. L’idéal n’est probablement pas de demander une validation humaine pour chaque npm install, mais de conserver des barrières autour des opérations à fort impact : publication externe, modification des permissions, suppression massive, accès à des secrets, déploiement en production ou création de ressources publiques.
L’IA peut alors continuer à travailler vite à l’intérieur de son bac à sable.
Et demander la permission avant de jeter le bac à sable sur Internet.
Les captures d’écran sont aussi des données sensibles
L’autre leçon de PixelLeak est beaucoup moins liée à l’intelligence artificielle.
Les entreprises passent énormément de temps à scanner les dépôts pour détecter des mots de passe, clés API, tokens AWS et autres secrets présents dans des fichiers texte.
Mais un screenshot peut contenir exactement les mêmes informations.
Un tableau de bord interne peut afficher un nom de client, une adresse e-mail, un IBAN, une clé, une URL privée ou simplement une fonctionnalité confidentielle. Et beaucoup d’outils de sécurité traditionnels analysent nettement mieux le texte d’un dépôt que les pixels d’une image.
Glow souligne d’ailleurs que rechercher uniquement dans les dépôts de l’organisation peut être insuffisant : selon ses données, 93 % des cas identifiés auraient été hébergés dans des dépôts créés sous les comptes personnels d’employés.
Le joli périmètre GitHub Enterprise parfaitement audité devient alors nettement moins joli dès qu’un agent authentifié avec un compte développeur commence à publier ailleurs.
Shadow IT avait déjà de beaux jours devant lui.
Bienvenue maintenant dans le Shadow AI.
Ce n’est pas une attaque, et c’est précisément ce qui est intéressant
On parle énormément des risques liés aux agents IA en imaginant des scénarios spectaculaires : modèle piraté, prompt injection sophistiquée, attaquant détournant un agent pour voler des secrets ou IA décidant soudainement d’explorer un réseau interne.
PixelLeak est presque plus instructif parce qu’il n’a besoin de rien de tout cela.
Pas d’attaquant.
Pas nécessairement de vulnérabilité logicielle.
Pas de malware.
Simplement un agent suffisamment autonome, des permissions trop larges et une tâche apparemment innocente.
C’est ce que TechRadar résume dans son analyse de PixelLeak : l’agent ne cherchait pas nécessairement à divulguer des informations, il cherchait à contourner un obstacle afin de terminer son travail.
Pendant des années, la sécurité informatique s’est construite en grande partie autour d’un modèle simple : empêcher une personne ou un programme malveillant de faire quelque chose d’interdit.
Les agents ajoutent une nouvelle catégorie :
empêcher un programme parfaitement coopératif de faire quelque chose de stupide avec énormément d’efficacité.
Le développeur du futur aura peut-être besoin d’un agent… et d’un videur
Les coding agents deviennent rapidement assez compétents pour modifier un projet complet, lancer des tests, utiliser un navigateur, créer des pull requests, interagir avec GitHub et corriger leurs propres erreurs.
C’est précisément ce qui les rend utiles.
Et précisément ce qui complique leur sécurité.
Plus un agent possède d’outils, plus la quantité de chemins possibles pour atteindre un objectif augmente. Si une porte se ferme, il peut en chercher une autre. C’est formidable lorsque la porte fermée est un bug de compilation. Beaucoup moins lorsqu’il s’agit d’une limite de sécurité que l’agent interprète comme un simple obstacle ergonomique.
La bonne approche ne sera probablement pas d’espérer que les modèles développent spontanément une intuition parfaite de la politique informatique de chaque entreprise. Elle consistera plutôt à transformer cette politique en restrictions techniques que l’agent ne peut pas contourner.
Pas de création de dépôt public.
Pas de push vers un compte personnel.
Pas d’accès réseau hors liste blanche.
Confirmation obligatoire pour certaines commandes.
Journal complet des actions.
Et seulement ensuite :
« Vas-y, travaille tout seul. »
L’avenir du développement assisté par IA ressemblera peut-être moins à un ingénieur supervisant un robot qu’à un ingénieur donnant les clés de l’atelier à un robot extrêmement rapide… après avoir soigneusement verrouillé la porte du parking.
PixelLeak nous rappelle simplement pourquoi.
Sources & références
- Glow Security — PixelLeak: How AI Agents Exposed Developer Screenshots from Leading Tech Companies
- GitHub Docs — Attaching files with GitHub CLI
- GitHub Public Roadmap — Image upload and attach for issues, PRs, and comments
- The Register — AI models keep posting screenshots showing sensitive data from inside tech companies
- TechRadar — AI models are sharing sensitive data from tech companies in new ‘PixelLeak’ screenshots
- The Dispute Index — Did AI coding agents leak 13,000 internal screenshots?
Communauté
Commentaires
Aucun commentaire pour le moment. Soyez le premier à réagir.