
À la une
Pangolin 1.23 : le reverse proxy Zero Trust auto-hébergé qui ne veut plus tomber avec un seul serveur
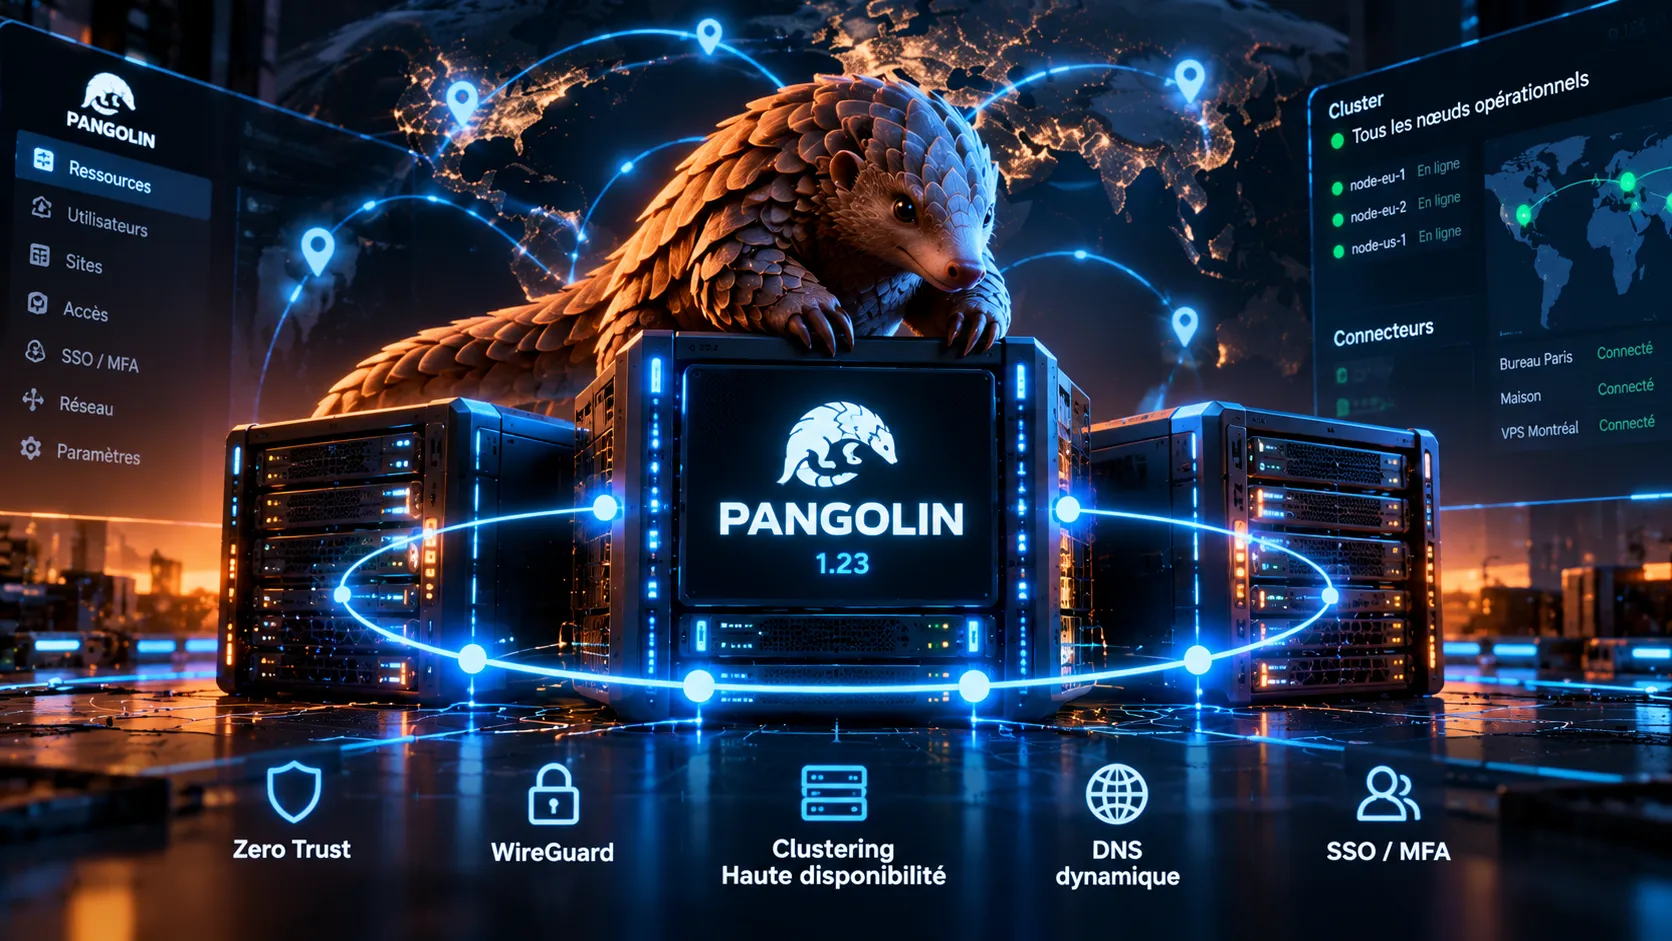
Pangolin s’est fait une place chez les amateurs de self-hosting en proposant une sorte de mélange entre reverse proxy, tunnel WireGuard, authentification centralisée et accès Zero Trust, sans obliger à exposer directement les services de son réseau sur Internet. Avec la version 1.23, le projet s’attaque maintenant à son principal défaut architectural : jusqu’ici, votre magnifique passerelle sécurisée pouvait toujours dépendre d’une seule machine. Pangolin peut désormais fonctionner en cluster haute disponibilité, avec partage d’état, bascule automatique, distribution régionale et certificats synchronisés. Le tout reste auto-hébergeable… avec toutefois une petite nuance côté licence pour les fonctions de clustering.
Le self-hosting possède une règle non écrite assez amusante : plus on sécurise son infrastructure, plus on finit par créer un composant extrêmement important dont dépendent tous les autres.
Vous installez un reverse proxy pour éviter d’exposer directement Jellyfin, Grafana, Home Assistant, votre NAS ou vos applications internes. Puis vous ajoutez de l’authentification, du SSO, du MFA et quelques règles d’accès. Vous félicitez ensuite votre propre génie pendant environ quinze minutes.
Puis le VPS qui héberge tout ça redémarre.
Et soudain, plus personne n’accède à rien.
C’est précisément le genre de problème auquel veut répondre Pangolin 1.23, publié le 15 septembre 2026. Cette nouvelle version apporte la possibilité de déployer soi-même plusieurs instances Pangolin fonctionnant comme un seul système, avec de la haute disponibilité et du clustering. Jusqu’à présent, cette architecture existait déjà chez l’éditeur, mais sa mise en place reposait notamment sur des composants propriétaires externes et nécessitait une intervention spécifique. Avec la 1.23, les fonctions nécessaires à cette architecture sont davantage intégrées dans Pangolin et leur déploiement est désormais documenté.
Et derrière le terme plutôt banal de « clustering », il y a ici beaucoup plus à résoudre que simplement lancer deux conteneurs Docker au lieu d’un.
Pangolin, c’est quoi exactement ?
Si vous ne connaissez pas encore le bestiau, Pangolin est une plateforme réseau auto-hébergeable construite autour de WireGuard et destinée à permettre l’accès sécurisé à des ressources privées.
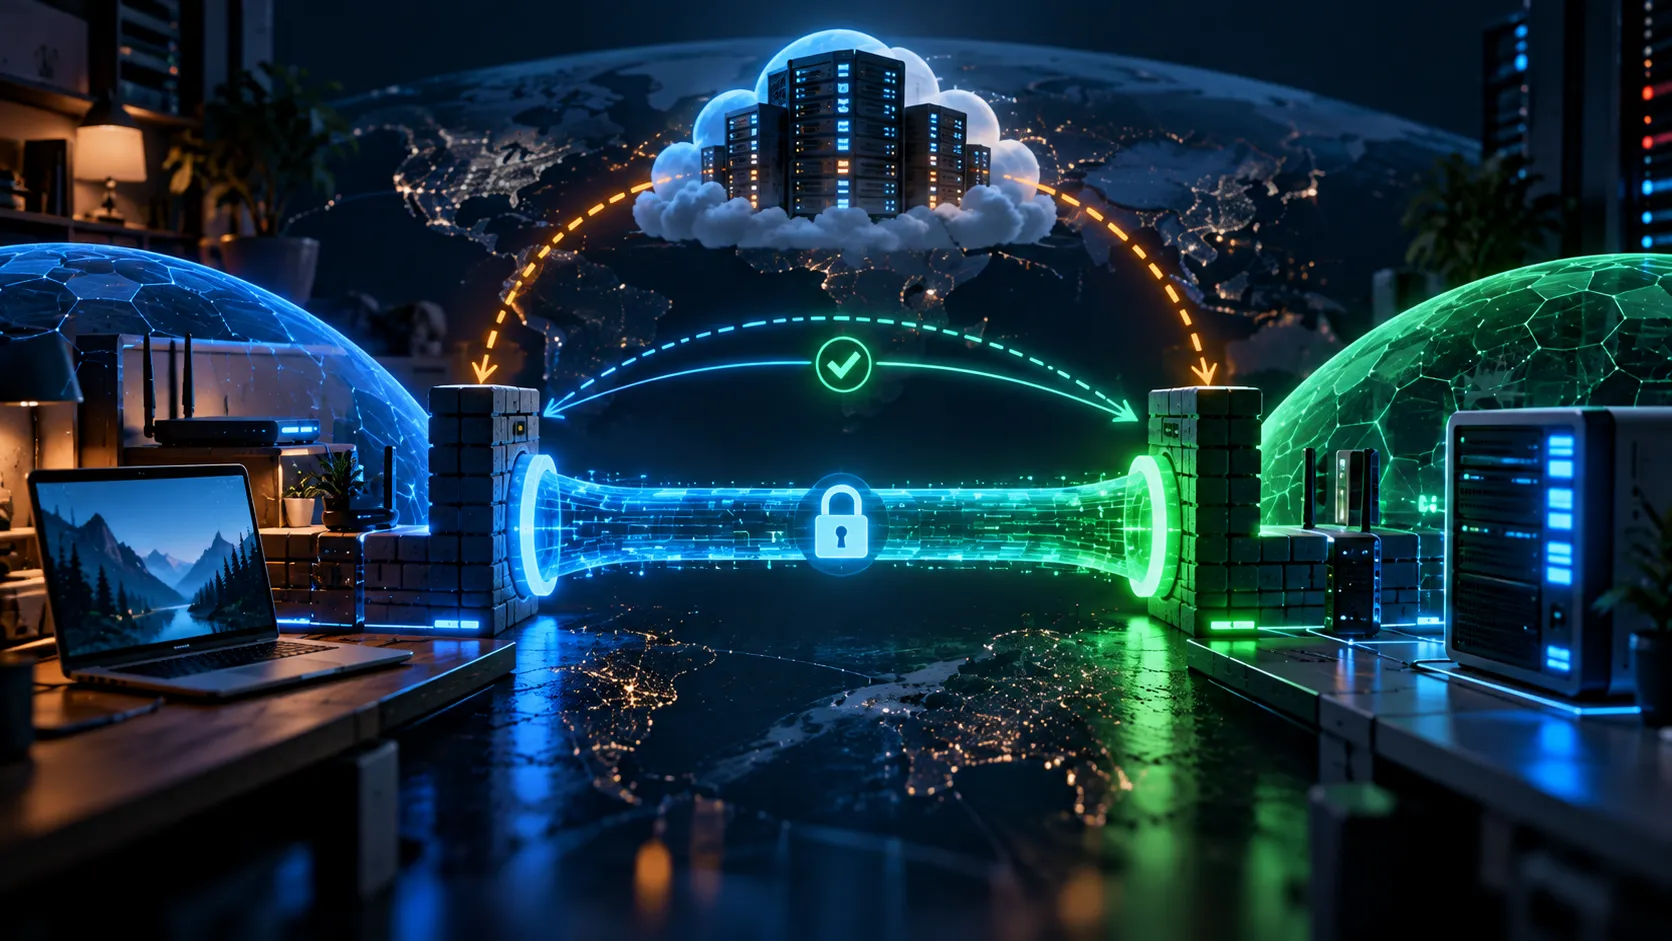
L’idée rappelle certains usages de Cloudflare Tunnel, Tailscale ou des architectures mêlant Traefik, WireGuard et une couche d’authentification : un connecteur est installé dans le réseau privé et établit une connexion sortante. Vous pouvez ensuite rendre certains services accessibles sans ouvrir directement leurs ports sur votre box ou votre pare-feu. Pangolin ajoute par-dessus une gestion des identités, des règles d’accès, du SSO, des accès SSH et différentes fonctions Zero Trust.
La Community Edition est gratuite, auto-hébergeable et distribuée sous AGPLv3. Pangolin propose également une édition commerciale contenant des fonctionnalités supplémentaires. Cette distinction va devenir importante un peu plus loin, parce que la haute disponibilité de la 1.23 ne débarque pas telle quelle dans la Community Edition.
Le projet est aujourd’hui disponible pour Linux, Windows, macOS, iOS et Android, tandis que ses connecteurs réseau utilisent des tunnels sortants et de la traversée de NAT pour accéder à des ressources situées derrière des pare-feu sans exiger une IP publique directement exposée.
Bref, le genre de plomberie réseau qu’on peut parfaitement monter soi-même avec suffisamment de WireGuard, Traefik, Authelia et café.
Pangolin essaie surtout de faire en sorte que vous n’ayez pas à le faire.
Le problème du serveur unique
Sur une installation classique, le serveur Pangolin possède énormément d’état en mémoire. Il maintient notamment des tunnels WireGuard vers les différents sites, des connexions WebSocket persistantes et des informations indiquant quelles ressources sont actuellement joignables derrière quel connecteur.
Tout va bien tant que cette machine reste disponible.
Mais démarrer une deuxième instance Pangolin à côté de la première ne suffit pas à fabriquer un cluster. Les deux processus ne savent pas spontanément quelle machine possède quel tunnel ni quel client est actuellement connecté à quel nœud.
C’est un problème particulièrement important pour un Identity-Aware Proxy. Avec un simple serveur web stateless, la recette de la haute disponibilité est relativement connue : plusieurs machines identiques derrière un load balancer et on laisse celui-ci distribuer le trafic.
Un proxy chargé de l’identité doit gérer beaucoup plus de choses. Les différents nœuds doivent disposer des mêmes utilisateurs, des mêmes politiques d’accès, des mêmes sessions et des mêmes certificats TLS. Sinon, un utilisateur authentifié sur le serveur A pourrait se retrouver soudainement inconnu du serveur B simplement parce que son navigateur a changé de nœud.
Pas terrible pour quelque chose qui est précisément censé décider qui peut entrer.
PostgreSQL pour la mémoire longue, Valkey pour les conversations rapides
Pour rendre Pangolin réellement distribuable, ses développeurs ont séparé son état en plusieurs catégories.
Les informations qui doivent être durables et partagées, comme les comptes, les ressources et les politiques d’accès, sont stockées dans PostgreSQL. Tous les nœuds du cluster consultent donc la même source de vérité.
Pour les événements plus temporaires, Pangolin utilise une couche compatible Redis, notamment Valkey, afin de mettre en place un mécanisme de publication/abonnement entre les serveurs.
Pourquoi ?
Parce qu’un utilisateur peut maintenir son WebSocket sur le nœud B alors qu’une action devant lui être envoyée est déclenchée sur le nœud A. Le serveur A publie alors le message sur le canal partagé ; le nœud qui possède réellement la connexion le récupère et le transmet au client.
Pour l’utilisateur final, il n’existe donc toujours qu’un seul Pangolin.
Sous le capot, plusieurs pangolins se parlent discrètement.
Oui, cette phrase avait besoin d’exister.
Même les certificats TLS deviennent une affaire de cluster
Les certificats représentent un autre petit problème sympathique.
Si quatre serveurs Pangolin constatent en même temps qu’un certificat Let's Encrypt doit être renouvelé et lancent tous leur propre challenge DNS-01, vous risquez rapidement de transformer un banal renouvellement TLS en compétition sportive.
Pangolin adopte donc un modèle où un seul nœud est responsable de l’émission et du renouvellement des certificats. Ceux-ci sont ensuite chiffrés et placés dans la base partagée. Les autres nœuds peuvent les récupérer et les écrire localement pour que Traefik puisse les utiliser.
L’avantage est évident : n’importe quel nœud du cluster peut ensuite terminer une connexion TLS pour les domaines protégés.
Et lorsqu’un serveur disparaît, il n’est plus nécessaire de découvrir avec horreur que la seule copie du certificat se trouvait justement sur le SSD qui vient de décider que huit ans de fonctionnement continu, c’était déjà très honorable.
Les sites choisissent eux-mêmes leur meilleur serveur
Le fonctionnement du failover côté connecteurs est également intéressant.
Lorsqu’un site Pangolin se connecte au cluster, il teste les différents nœuds disponibles via un endpoint de type ping puis sélectionne celui répondant le plus rapidement.
Cela produit indirectement un mécanisme de préférence géographique sans devoir créer manuellement des régions.
Imaginez un serveur Pangolin à Paris et un autre à Montréal. Un connecteur situé en France devrait naturellement mesurer une latence plus faible vers Paris et choisir ce nœud. Un site canadien pourra faire l’inverse.
Si le serveur utilisé disparaît, le connecteur détecte la panne, recherche une autre instance disponible et recrée son tunnel vers elle. Le système contient également des mécanismes destinés à éviter qu’un connecteur oscille en permanence entre deux nœuds présentant presque la même latence.
Ce n’est donc pas simplement du load balancing HTTP.
Les tunnels réseau eux-mêmes deviennent capables de déménager.
Le DNS devient beaucoup moins ennuyeux qu’il n’en a l’air
La partie probablement la plus amusante techniquement concerne le DNS.
Dans un cluster Pangolin, une ressource privée n’est pas nécessairement joignable depuis tous les serveurs de la même manière. Son tunnel peut actuellement terminer sur le nœud A puis, après une panne ou une reconnexion, terminer sur le nœud B.
L’adresse à retourner dépend donc de l’endroit où se trouve réellement le tunnel à cet instant précis.
Pangolin intègre pour cela son propre serveur DNS autoritaire capable de répondre en fonction de l’état actuel du cluster. Le domaine d’une ressource peut ainsi être résolu vers le nœud qui possède effectivement la connexion correspondante.
Cette architecture impose de déléguer un sous-domaine au cluster afin que Pangolin puisse contrôler directement ces réponses DNS.
On commence donc avec « j’aimerais accéder à mon Grafana sans ouvrir le port 3000 ».
Et quelques mois plus tard, on administre un DNS autoritaire distribué avec plusieurs proxies WireGuard.
Le self-hosting dans toute sa splendeur.
Et si votre navigateur possède encore une vieille réponse DNS ?
Évidemment, les caches DNS existent.
Après un failover, un navigateur peut parfaitement continuer pendant quelque temps à envoyer son trafic vers l’ancien nœud. Pangolin devait donc résoudre un dernier problème : comment le mauvais serveur peut-il transmettre la connexion au bon sans casser le chiffrement ?
Le composant réseau peut examiner le nom de serveur présent dans le handshake TLS afin de déterminer quelle ressource est demandée. Si le tunnel concerné se trouve sur un autre nœud, il ouvre une connexion vers celui-ci et lui transmet le flux chiffré.
Le serveur intermédiaire n’a donc pas besoin de déchiffrer les données applicatives. Il joue essentiellement le rôle de facteur très rapide : « ce paquet n’est pas pour moi, la bestiole que vous cherchez est deux racks plus loin ».
Normalement, le DNS doit déjà diriger directement le client vers le bon nœud. Ce relais sert essentiellement à absorber les moments transitoires, notamment pendant un failover ou lorsqu’un client conserve une ancienne résolution en cache.
Voilà le genre de détail qui sépare souvent « nous supportons le clustering » de « nous avons réellement essayé d’éteindre l’un des serveurs pendant que quelqu’un travaillait ».
Newt commence également à disparaître derrière la CLI Pangolin
Pangolin 1.23 apporte une autre évolution plus visible pour les administrateurs.
Jusqu’ici, le connecteur installé sur les réseaux privés s’appelait Newt. Il reste disponible et les déploiements existants continuent de fonctionner, mais le projet commence à intégrer directement ce rôle dans la CLI Pangolin.
On peut désormais démarrer un site directement avec la CLI et installer celle-ci comme service permanent sur Linux, macOS ou Windows. Sous Linux, cela passe notamment par systemd.
Le projet explique vouloir progressivement fournir un seul outil en ligne de commande pour les fonctions Pangolin, plutôt que demander aux administrateurs de jongler entre plusieurs exécutables.
Newt n’est néanmoins pas supprimé : il reste plus léger puisqu’il n’embarque pas les autres fonctions de la CLI et continuera d’être fourni pour les utilisateurs qui souhaitent uniquement le connecteur réseau.
Un rare exemple de transition logicielle où « déprécié à terme » ne signifie pas encore « supprimé mardi prochain parce que surprise ».
Plusieurs admins, parce que partager le mot de passe root n’était pas une fonctionnalité
La version 1.23 apporte également plusieurs améliorations plus classiques à l’administration.
Il est maintenant possible de déclarer plusieurs administrateurs du serveur, puis de promouvoir ou rétrograder un utilisateur depuis l’interface. Le panneau d’administration reçoit également une vue regroupant toutes les organisations hébergées sur une instance, avec leur propriétaire et le nombre d’utilisateurs, de sites et de ressources.
Le Resource Launcher affiche davantage d’informations sur les sites permettant d’atteindre une ressource et fournit directement une commande pangolin ssh pour certaines ressources SSH privées.
Ce ne sont pas les nouveautés qui feront hurler YouTube avec une miniature « INTERNET CHANGED FOREVER ».
Mais si vous administrez réellement une instance avec plusieurs personnes, ne plus dépendre du compte administrateur unique de Gérard constitue objectivement un progrès.
Attention : toute la haute disponibilité n’arrive pas gratuitement dans la Community Edition
C’est probablement la nuance la plus importante de cet article.
Pangolin possède bien une Community Edition sous AGPLv3, gratuite et open source. En revanche, la nouvelle fonction de clustering haute disponibilité de la version 1.23 est proposée dans l’offre auto-hébergée Scale et dans les contrats Enterprise.
Pangolin indique néanmoins que les clés commerciales correspondantes sont gratuites pour un usage personnel et hobby, ainsi que pour les organisations situées sous son seuil de revenus. Le README actuel précise que l’Enterprise Edition est gratuite pour les particuliers, les hobbyistes et les entreprises réalisant moins de 100 000 dollars de chiffre d’affaires annuel brut.
Il ne faudrait donc pas résumer la sortie par « Pangolin ajoute gratuitement le clustering à son édition open source ».
Ce n’est pas exactement ce qui se passe.
Le cœur communautaire reste open source et auto-hébergeable, mais certaines fonctions avancées suivent un modèle open-core.
Pour un homelab personnel, les conditions restent intéressantes. Pour une entreprise dépassant les seuils prévus, il faudra regarder la licence et la tarification avant de dessiner un cluster à douze nœuds sur le tableau blanc.
Faut-il remplacer Nginx Proxy Manager, Traefik ou Cloudflare Tunnel demain matin ?
Pas nécessairement.
Pangolin résout un problème différent d’un simple reverse proxy.
Si vous possédez un VPS public hébergeant trois sites web, Nginx ou Traefik restent parfaitement adaptés. Ajouter une plateforme complète de réseau Zero Trust uniquement pour afficher votre blog WordPress serait légèrement enthousiaste.
L’intérêt apparaît lorsque les services sont dispersés derrière plusieurs réseaux privés, NAT ou pare-feu et que vous souhaitez centraliser l’identité et les autorisations plutôt que simplement transférer des paquets.
Pangolin peut alors éviter d’exposer directement les services internes et utiliser ses connecteurs pour créer les chemins réseau nécessaires.
La version 1.23 rend surtout cette architecture beaucoup plus crédible lorsqu’elle devient critique.
Parce qu’un système Zero Trust installé sur un seul VPS possède une conception assez originale du mot « haute disponibilité ».
Le vrai luxe du self-hosting : pouvoir casser deux serveurs au lieu d’un
Pangolin 1.23 illustre finalement assez bien la maturation actuelle des outils réseau auto-hébergés.
Pendant longtemps, ce genre de projet cherchait surtout à prouver qu’on pouvait recréer soi-même une alternative à un service cloud : déployer quelques conteneurs, pointer un domaine vers le VPS et célébrer la souveraineté retrouvée.
Puis vient la deuxième étape.
Les sauvegardes.
La supervision.
Les mises à jour.
Le failover.
Les certificats.
La base de données.
Le DNS.
Et soudain, on comprend pourquoi les fournisseurs cloud facturent ce qu’ils facturent.
Avec son clustering, Pangolin commence justement à franchir cette deuxième étape. Le projet ne se contente plus de proposer un tunnel WireGuard avec une jolie interface : il cherche à rendre la couche d’accès elle-même tolérante aux pannes, avec un véritable partage d’état et des mécanismes capables de déplacer dynamiquement les connexions.
Pour le homelabber qui veut simplement consulter Home Assistant depuis son téléphone, tout cela est probablement excessif.
Pour quelqu’un qui utilise Pangolin comme porte d’entrée vers une infrastructure professionnelle, beaucoup moins.
Parce que le Zero Trust, c’est très bien.
Le Zero Access parce que votre unique VPS est mort, nettement moins.
Sources & références
Communauté
Commentaires
Aucun commentaire pour le moment. Soyez le premier à réagir.